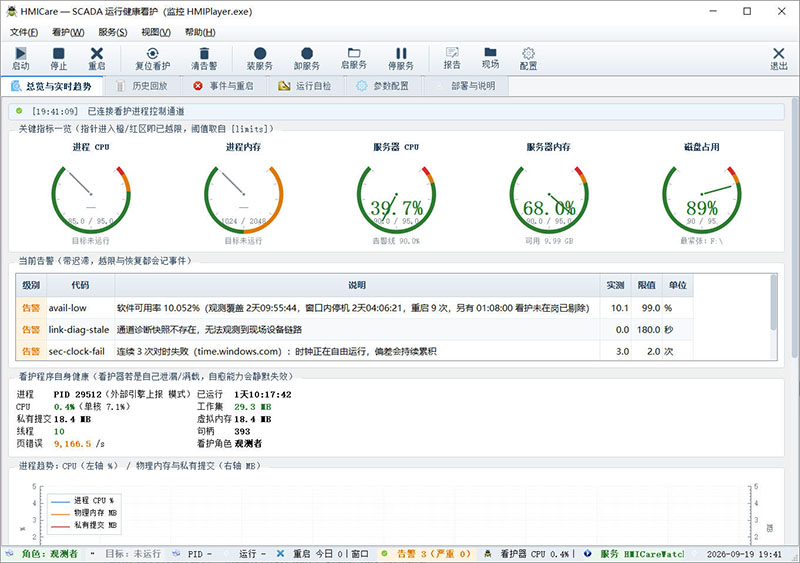
5.1 设计目标与定位
SCADA 系统上线之后,真正的风险往往来自「软件自身的长期运行状态」,而不是「现场设备」。现场反复出现的失效模式有:
| 典型失效模式 | 现场表现 | HMICare 的应对 |
|---|---|---|
| 进程崩溃 / 挂起 | 运行站意外退出或消息循环卡死,画面停留在最后一帧 | 崩溃、挂起、内存越限自动拉起;重启前抓 minidump 与画面截图 |
| 内存单向增长 | 进程 RSS 逐日上涨,最终 OOM 或被运维定期重启 | 最小二乘斜率判定「正常波动」与「泄漏」;到线主动重启保护 |
| 静默功能失效 | 进程没崩,但已不再写历史库 / 不再发布报警 | 关键功能探针(HTTP / TCP / file / process)+ 数据新鲜度判定 |
| 磁盘写满 | 历史库所在分区占满,归档无声停止,数据正在丢失 | 逐卷容量与 I/O 延迟监测、历史库「多久没写入」直接告警 |
| 链路劣化 | 到 PLC/RTU 丢包、超时、扫描落后,界面数据不再刷新 | 读取运行站的通道诊断快照,逐设备在线/离线/隔离与 RTT/丢包统计 |
| 时钟不一致 | 多机 SOE 时间错位,事故分析时事件顺序无法对齐 | SNTP 对时偏差 + 本地时钟阶跃检测,并在消息中写明快/慢方向 |
| 审计缺失 / 被篡改 | 关键操作无留痕,或操作日志被修改 | 看护自身操作写入 SHA-256 哈希链,只读消费 SCADA 操作审计日志 |
| 看护器自身失效 | 自愈能力静默消失,无人察觉 | 对看护器自身做同等体检(句柄/内存增长、CPU 满载)并告警 |
5.1.1 两组能力模型
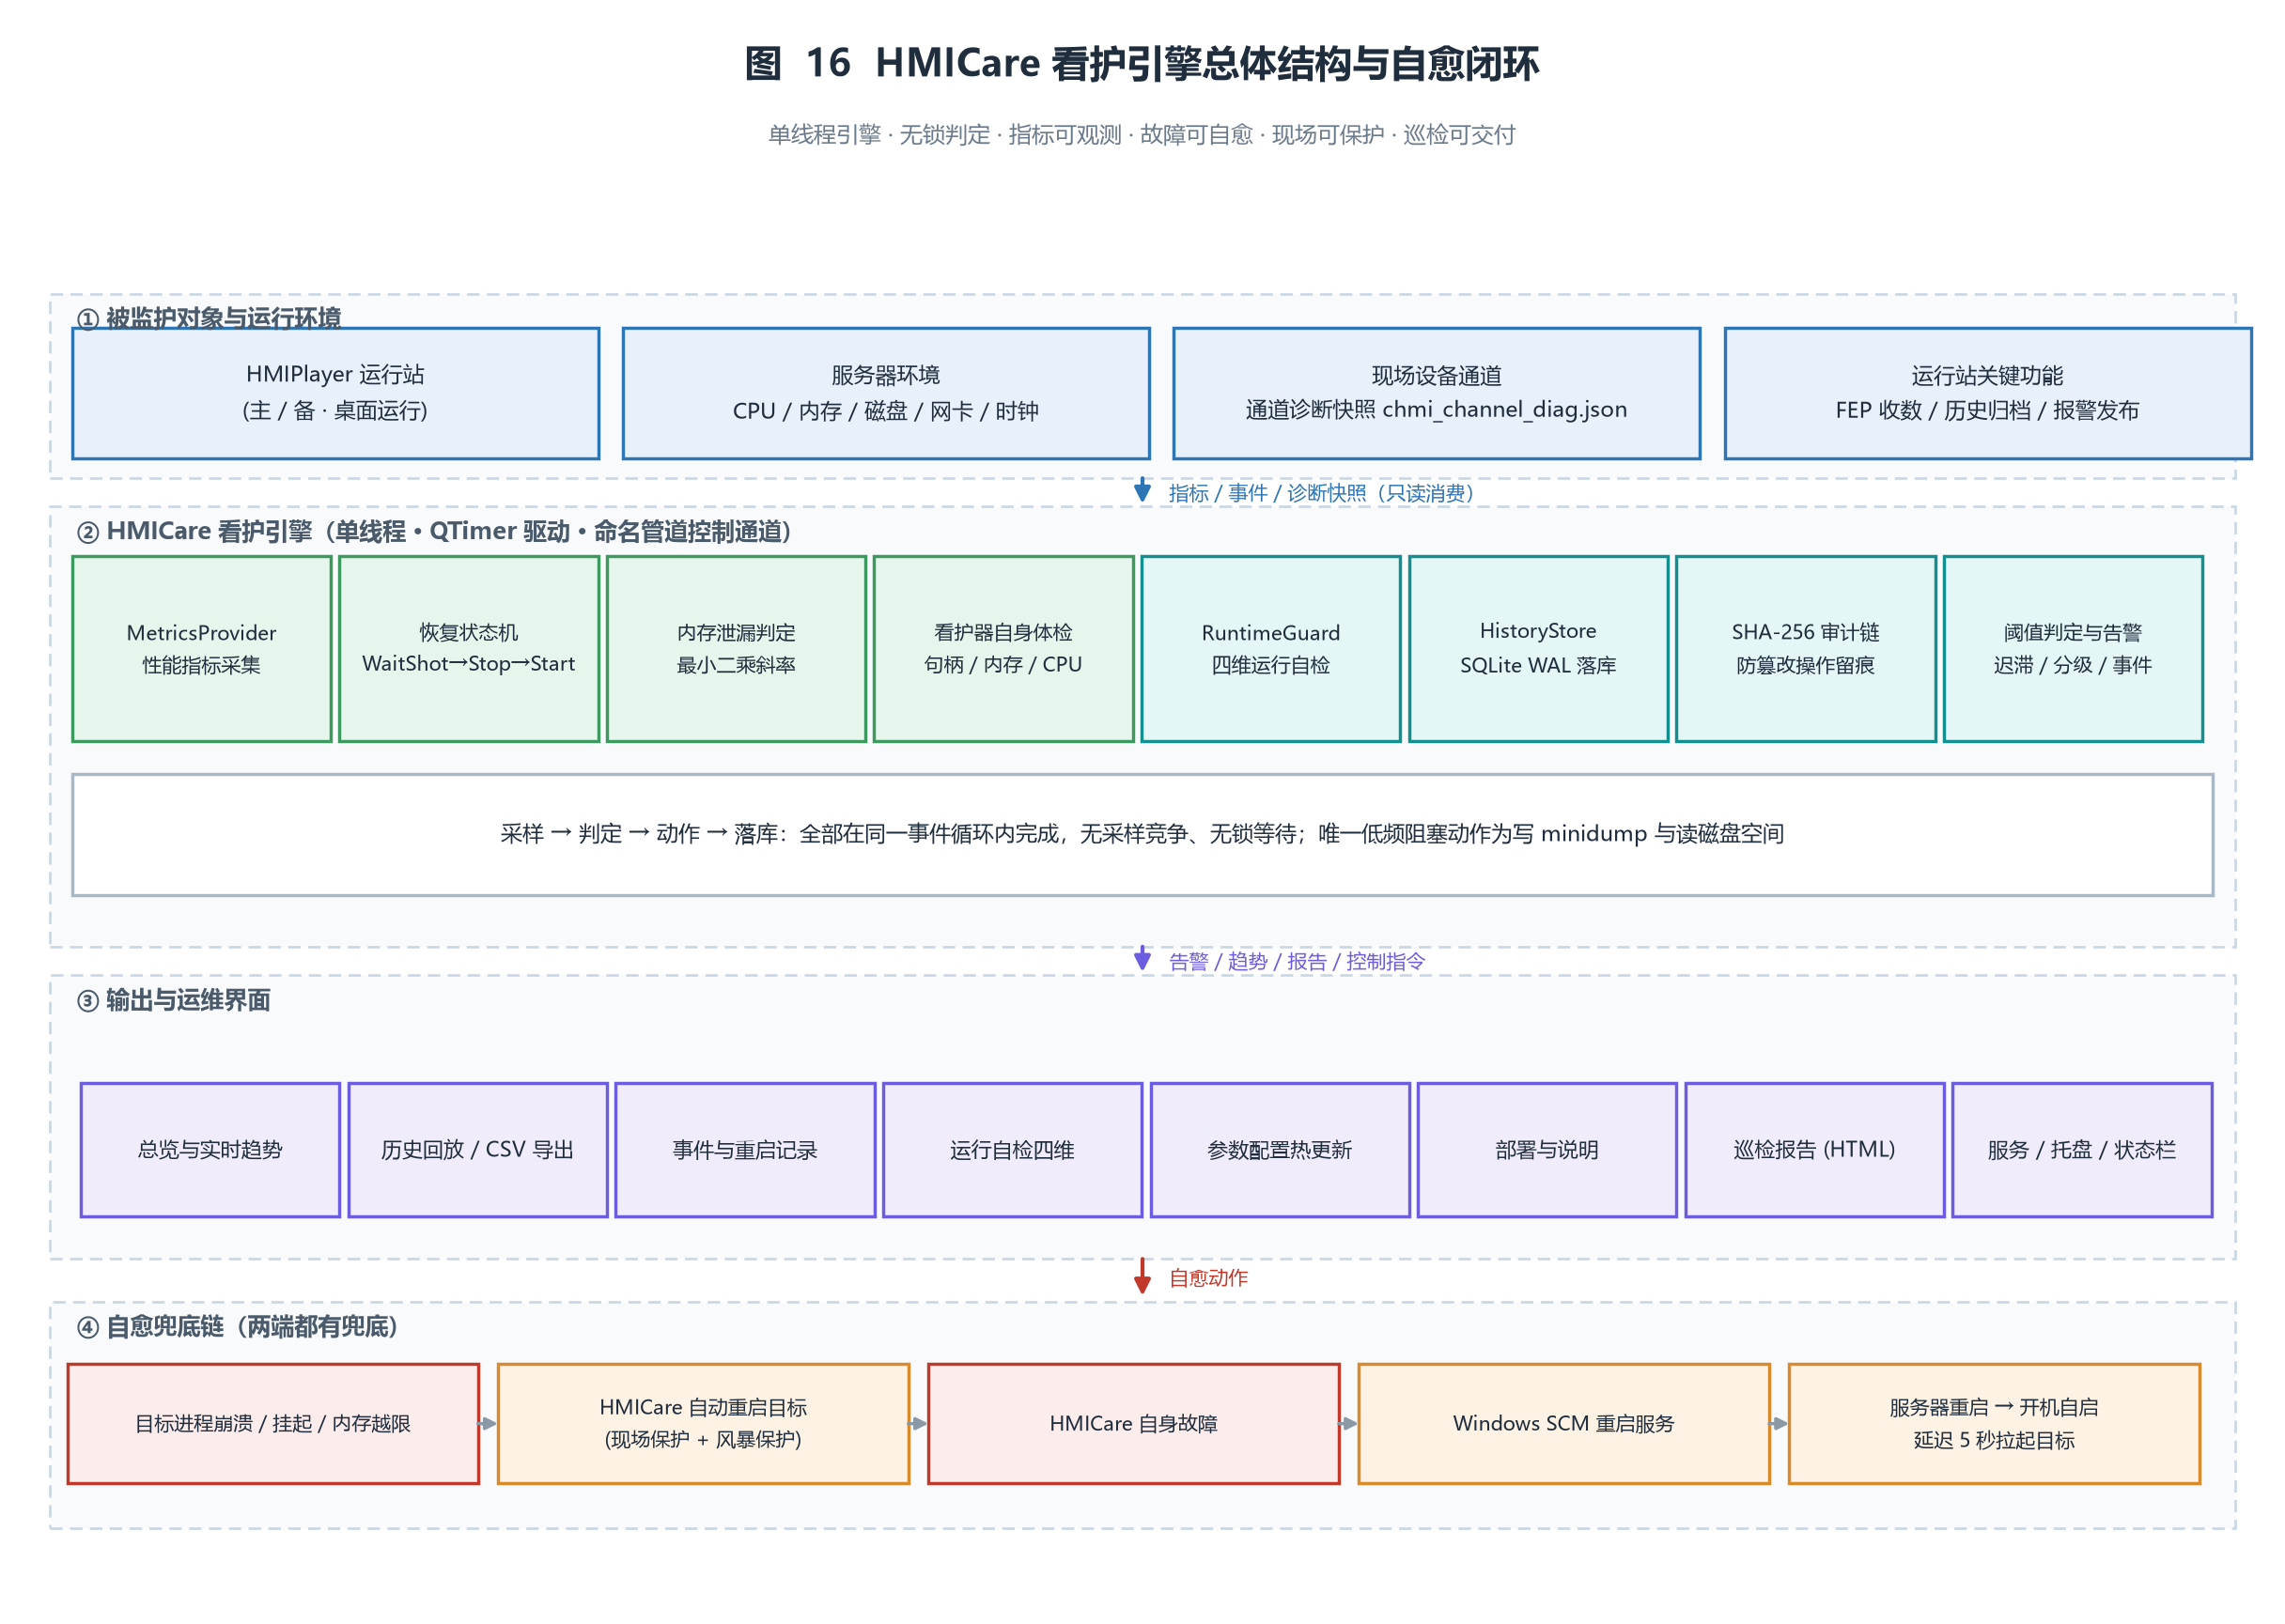
| 能力组 | 覆盖维度 | 回答的问题 |
|---|---|---|
| 第一组:进程与服务器 | 性能指标监控、故障自动重启、内存精细化管理、看护器自身体检 | 目标进程与服务器还活着吗?CPU/内存/句柄/线程/IO 是否异常? |
| 第二组:环境与功能 | 磁盘与存储、网络与通信链路、运行安全与访问审计、运行状态与可用性 | 软件还能不能持续干活?它所在的环境是否正常? |
5.2 体系结构与运行形态
HMICare 采用单线程看护引擎:采样、判定、重启、落库全部跑在创建它的事件循环里,仅由 QTimer 驱动,不创建任何线程。这带来两个工程收益——没有采样竞争、没有锁等待;同时行为完全可预期(唯一会短暂阻塞的是低频的 minidump 写盘与磁盘空间读取)。
5.2.1 三种运行形态
| 形态 | 启动方式 | 适用场景 | 特点 |
|---|---|---|---|
| 界面自带看护 | 双击 hmicare.exe | 调试、单机、临时巡检 | 界面进程自己抢到看护角色,立刻开始监护与自愈 |
| 服务化(推荐生产) | hmicare.exe --install --start | 7×24 运行 | 开机自启 + SCM 失败自动重启;无人登录也在岗 |
| 前台守护 | hmicare.exe --console | 现场排查 | 无界面,日志直接打到控制台,最容易看清正在做什么 |
界面与服务可以同时运行而不冲突:二者通过命名管道通信,并由命名互斥体 Global\HMICareWatchdogRole 保证同一时刻只有一个「看护者」。先拿到角色的一方执行监护与重启,另一方自动退化为只读观测 + 指令下发。状态栏第一格会明确标注当前角色,避免运维误判「谁在管事」。
5.2.2 自愈兜底链
目标进程崩了    →  HMICare 重启它(带重启风暴保护与退避)
HMICare 崩了    →  Windows SCM 重启 HMICare(服务化部署)
服务器重启了    →  服务开机自启 → 延迟 5 秒 → 拉起目标
两端都有兜底,这是「专业看护」与「脚本轮询重启」的本质区别:脚本一旦自己被杀,整条自愈链就断了,而系统不会有任何提示。
5.2.3 控制通道与角色互斥
服务运行在 Session 0、界面运行在交互会话,两者是不同进程。它们通过本地命名管道交换快照与控制指令:真正执行监护的一侧启动 ControlServer,另一侧以 ControlClient 异步收发(同一时刻只发一条请求,收到回复再发下一条,不阻塞事件循环)。
| 指令 / 通道 | 方向 | 用途 |
|---|---|---|
| 快照(snapshot) | 引擎 → 界面 | 状态、PID、运行时长、当前告警、最近事件与重启、看护器自身开销;含实时环形缓冲(趋势用) |
deep | 界面 → 引擎,按需拉取 | 四维自检明细(逐卷 I/O、设备清单、探针、关键功能)。刻意不放进每拍快照——设备多的现场可达数十 KB,每 2 秒塞进管道会白白浪费带宽 |
selfcheck | 界面 → 引擎 | 不等周期,立即重跑历史库探针与关键功能检查 |
cleanup | 界面 → 引擎 | 按策略清理陈旧文件。弹窗二次确认,且操作写入防篡改审计链 |
start / stop / restart / reset / clearAlarms | 界面 → 引擎 | 对应工具条的启动/停止/重启/复位看护/清告警;stop 是「人工停机」语义 |
clientsChanged | 引擎 → 界面 | 客户端接入/断开时留痕与提示(审计用) |
角色互斥由命名互斥体 Global\HMICareWatchdogRole 保证:服务与界面都可能具备看护能力,但同一时刻只有一个真正执行重启,否则会出现「双看护互抢」把进程反复重启。判角色时必须用只观察不抢占地探测(watchdogRoleBusy() + 读 var/watchdog.pid),而不是查「本进程是否持锁」——后者在独立进程里永远为 false,会让 --status 误报「无人看护」。
var/watchdog.pid)是一个小而有用的设计:运维在任意一台机器上执行 hmicare.exe --status,就能知道「现在到底是谁在看护、被监护进程的 pid 是多少」,而不必登录到服务宿主或交互会话去翻进程列表。5.2.4 服务宿主的线程约束
Windows 服务的 ServiceMain 由 SCM 在另一个线程上回调,而 Qt 的事件循环与 QTimer 必须活在本进程创建它们的那个线程。因此实现上让 SCM 调度器(StartServiceCtrlDispatcher)跑在一个独立线程上,Qt 主事件循环留在主线程,两边用互斥体 + 条件变量握手,服务控制码(停止/暂停等)只置原子标志、由主线程轮询处理。
这带来两个结果:引擎本身仍是单线程的(采样、判定、重启、落库都在主事件循环内),没有锁与竞争;而服务控制不会因为在错误线程等待而挂死。安装服务时一次性配好「开机自启 + 延迟启动 + SCM 级失败自动重启(5 s / 15 s / 60 s 三次)」——这是自愈链路的最后一道保险。
5.3 故障自愈与现场保护
自愈不是「发现不在就拉起」这么简单。工业现场需要回答三个问题:为什么重启(原因可追溯)、重启前有没有留下现场(可分析)、会不会越重启越糟(风暴保护)。
5.3.1 恢复状态机
| 阶段 | 动作 | 说明 |
|---|---|---|
| WaitShot | 请求用户会话助手抓取画面截图 | 服务运行在 Session 0,看不到交互桌面,需助手跨会话抓图 |
| Stop | 先发 WM_CLOSE 优雅关闭,超时才强杀 | 给目标进程落盘与收尾的机会 |
| Start | 重新拉起并在确认窗口内验证进程存活 | 拉起失败会累计,避免「拉不起还一直拉」 |
5.3.2 重启风暴保护
| 保护机制 | 默认值 | 作用 |
|---|---|---|
采样周期 sampleIntervalMs | 2000 ms(现场常见 1000~5000) | 判定与恢复的节拍 |
窗口内允许重启次数 maxRestartsInWindow | 6 次 / 600 秒 | 抑制短时间反复重启 |
累计失败放弃阈值 giveUpAfter | 24 次 | 环境问题未解决时停止无意义重启,避免反复破坏现场 |
| 放弃后复位 | F8 / 复位看护 | 现场环境修好后让自愈重新生效 |
| 故障后重启延时 | 可配置退避 | 给现场设备与网络恢复的时间 |
5.3.3 现场保护
var/crash,可直接交 WinDbg/cdb 分析。停止 (F6) 是「优雅停止且不再自动拉起」,看护会记住这个决定;只有再次手动启动或复位看护后,自愈才会重新生效。这避免了运维主动停机后被立刻拉起的尴尬。5.4 内存精细化管理
内存治理要区分两类现象:正常业务波动与单向泄漏。把前者当泄漏会误重启,把后者当波动会等到 OOM。
| 机制 | 判定方式 | 默认参数 | 动作 |
|---|---|---|---|
| 阈值主动保护 | 进程物理内存 / 虚拟内存超过重启线即重启,不等崩溃 | 告警 1024 MB / 重启 2048 MB | 重启(可配置) |
| 泄漏斜率判定 | 在工作集样本窗口上做最小二乘拟合,斜率持续为正且超过增长上限 | maxRssKbPerHour=4096,多窗口连续复核 | 默认只告警,可选主动重启 |
| 线性增长复核 | 需连续多个复核窗口同向,过滤启动预热与阶段性缓存 | 统计窗口 + 连续复核窗口数 | 降低误报 |
| 看护器自身体检 | 对看护器自己的句柄数、线程数、工作集、CPU 做同等判定 | 工作集 > 256 MB、CPU 长期 > 25% | 只告警,不自动重启自己 |
kSoakMaxRssKbPerHour 对齐,保证「看护的判据」与「运行站自身的长稳目标」保持一致;看护器不自动重启自己,是为了避免「看护器重启看护器」把现场彻底搞乱。5.5 运行自检:四维环境与功能体检
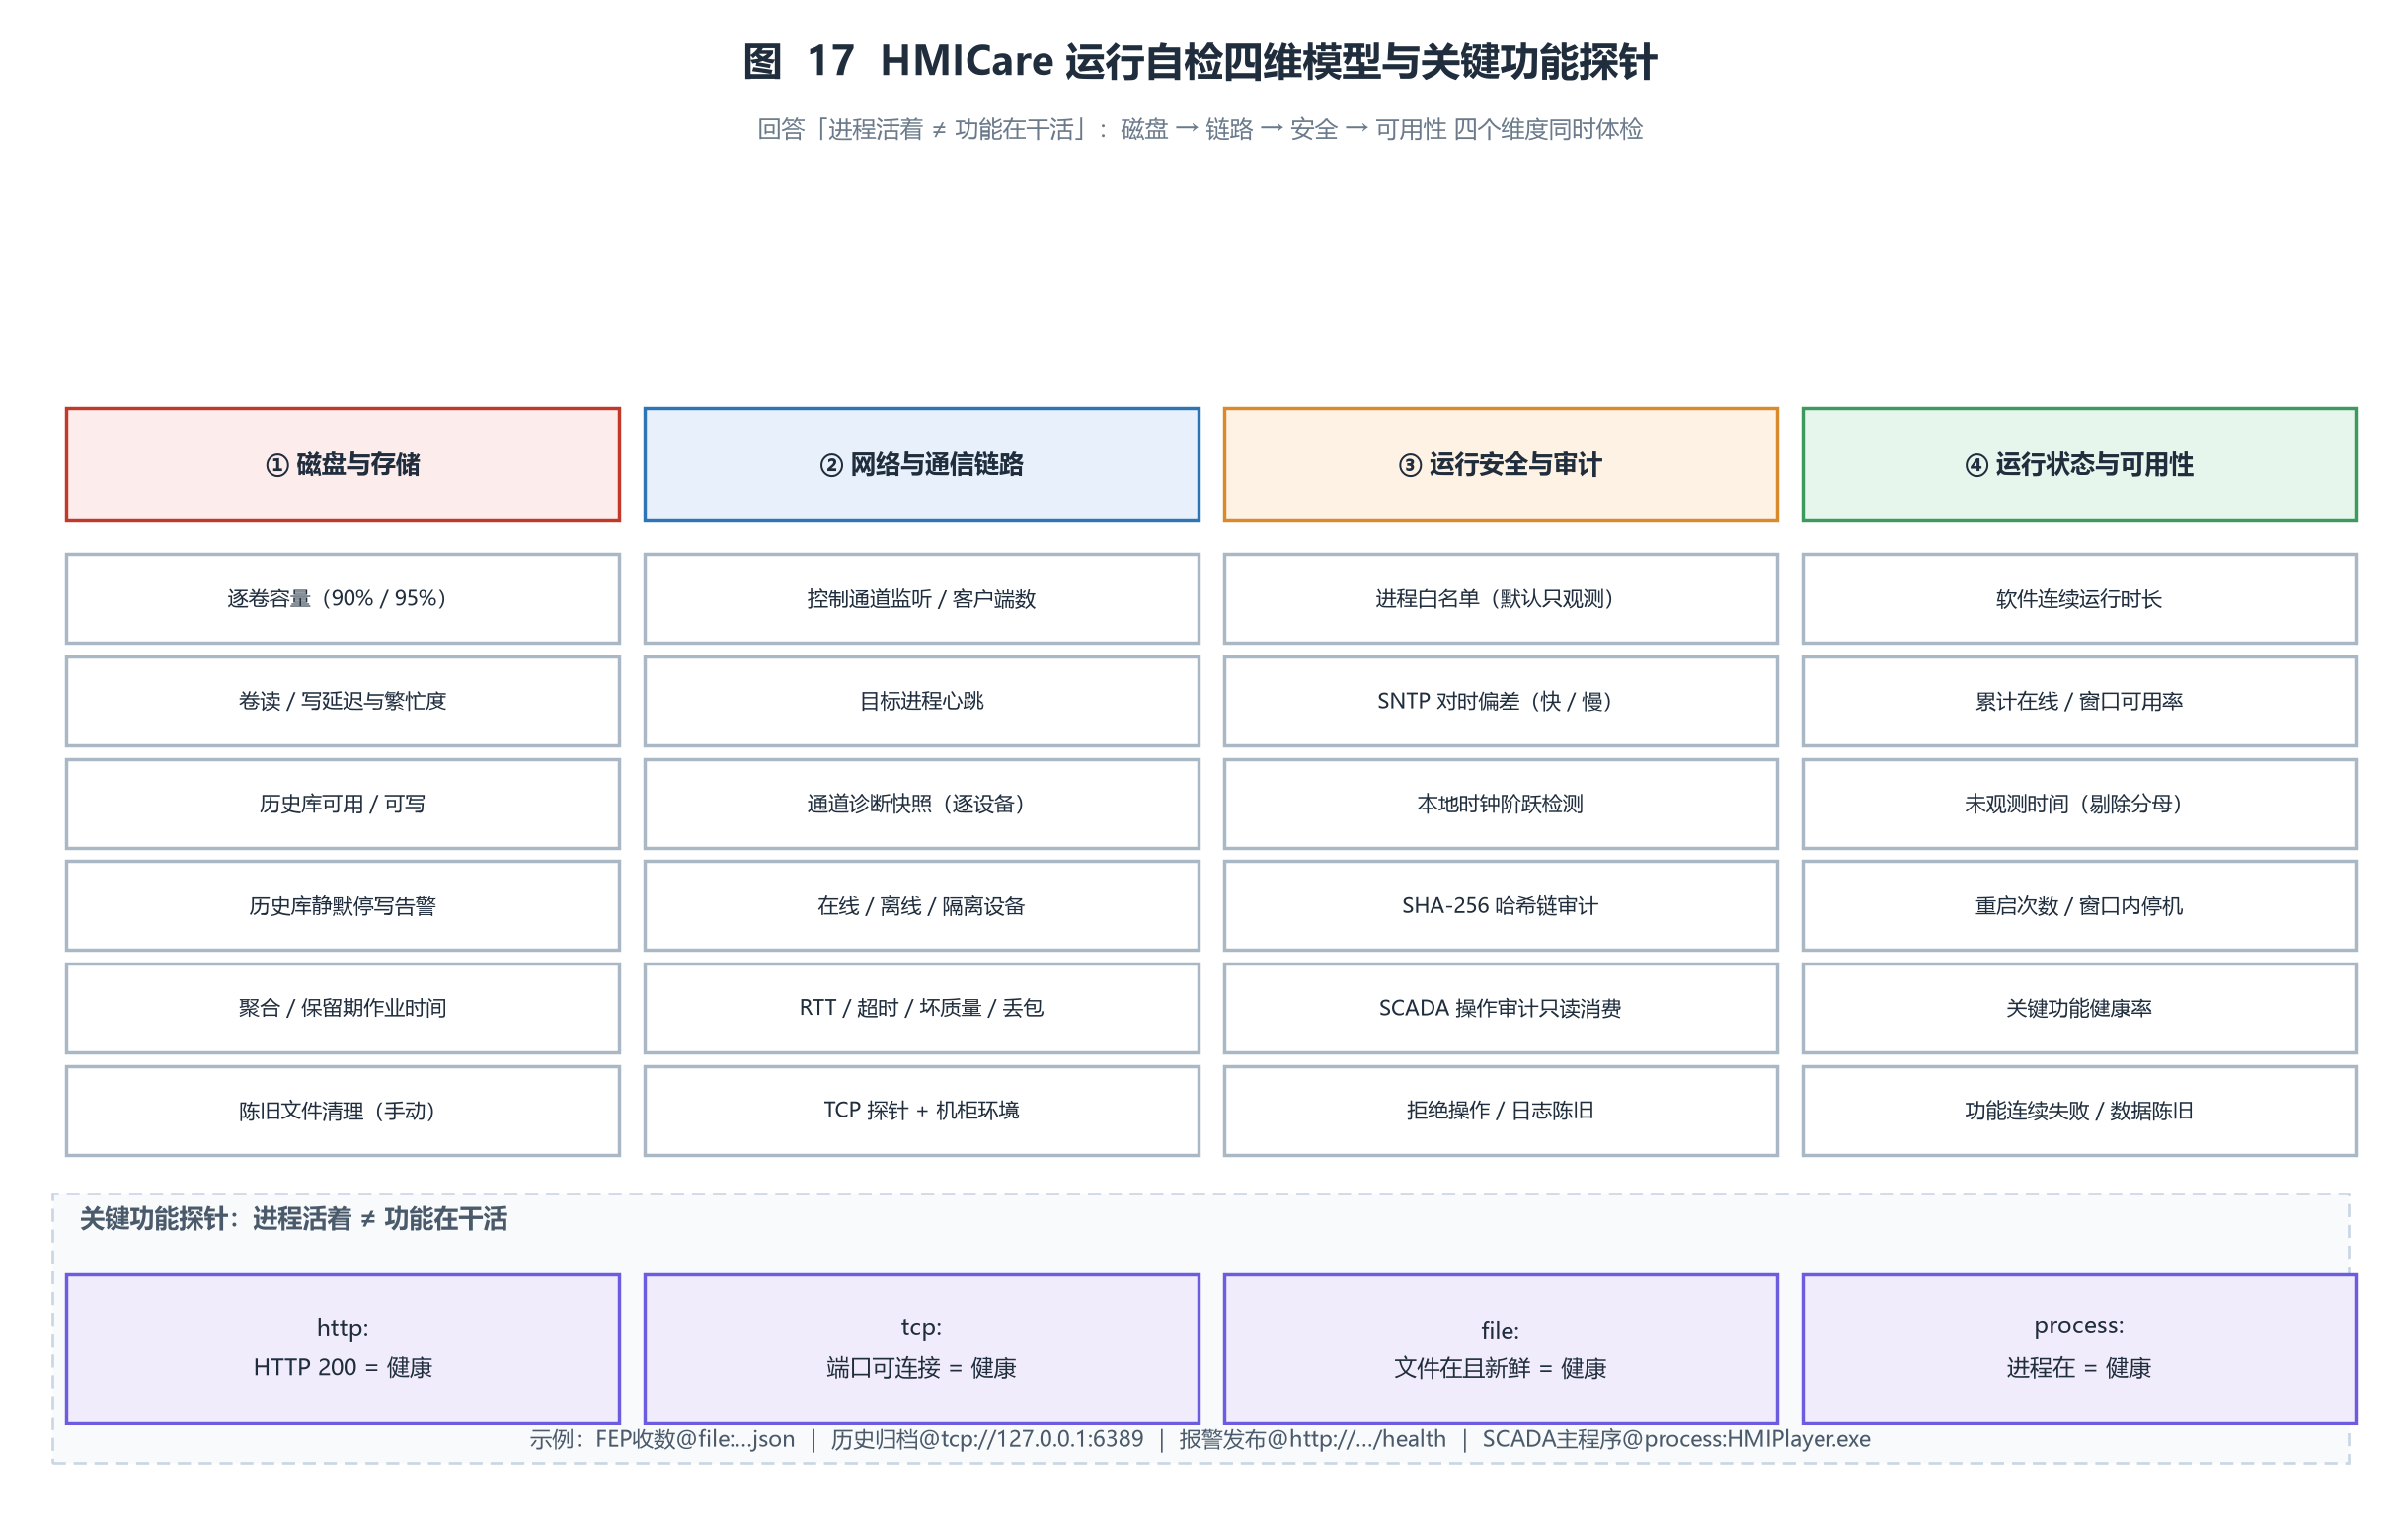
5.5.1 磁盘与存储
% Disk Time,区分「延迟高是因为盘忙」还是「盘本身不行」(经验线 100 ms / 严重 250 ms)。storage-db-stale:历史库超过 N 分钟没有写入即告警——这是数据正在丢失的直接信号。5.5.2 网络与通信链路
chmi_channel_diag.json,得到逐设备的在线/离线/隔离数、扫描周期与落后、RTT、超时事件、坏质量点与估算丢包率。5.5.3 运行安全与访问审计
operator_journal.log(在线改限值、趋势配置、登录登出等)。5.5.4 运行状态与可用性
| 指标 | 口径 | 说明 |
|---|---|---|
| 软件连续运行时长 | 被监护进程本次连续在岗时间 | 不等于服务器开机时长,这才是 SCADA 可用性口径 |
| 累计在线秒 | 跨看护重启累加,定期快照入 SQLite | 据此计算窗口可用率 |
| 窗口可用率 | 观察窗口内在线时间占比 | 观察窗口 = 首次观测至今 |
| 未观测时间 | 看护自身不在岗的时段 | 既不算在线也不算停机,从分母剔除并单列 |
| 关键功能健康率 | 健康功能数 / 已检查功能数 | 回答「进程活着但功能是否在干活」 |
5.5.5 关键功能探针
FEP收数@file:C:\scada\chmi_channel_diag.json     # 文件在且新鲜 = 健康
历史归档@tcp://127.0.0.1:6389                     # 可连接 = 健康
报警发布@http://127.0.0.1:8080/api/v1/health      # HTTP 200 = 健康
SCADA主程序@process:HMIPlayer.exe # 进程在 = 健康四类探针(http: / tcp: / file: / process:)覆盖了「服务是否响应」「端口是否可连」「数据是否新鲜」「进程是否存在」四种典型健康语义;并支持单次超时、连续失败告警与数据陈旧告警,避免单次抖动造成误报。
5.5.6 「静默失效」的判定规则
四维自检真正要抓的是静默失效:进程在、端口通,但业务已经不再产生新数据。这类故障不会触发任何重启逻辑,因此必须靠「新鲜度」与「增量」来判定。
| 静默失效形态 | 判定依据 | 默认阈值 |
|---|---|---|
| 历史库停写 | 最近一次采样落库时间距今过久(dbStaleWarnMin) | 10 分钟 |
| 通道诊断快照停更 | 目标写出的快照文件 mtime 过旧(diagStaleWarnSec) | 180 秒(写入周期 60 s) |
| 关键功能数据陈旧 | file: 类探针成功但文件不新鲜(functionStaleWarnSec) | 300 秒 |
| 聚合 / 保留期作业未执行 | 作业时间戳超过预期周期(storage-job-rollup / storage-job-retention) | 按分钟聚合与保留期清理周期 |
| 审计日志不再增长 | SCADA 操作审计日志长时间无新记录(sec-journal-stale) | 按配置周期 |
| 机柜环境采集停摆 | 环境信号 JSON 陈旧(link-env-stale) | 120 秒 |
| 看护器自身失去自愈能力 | 看护器句柄/工作集单向增长、CPU 长期高于 25% | 工作集告警 256 MB、CPU 25% |
failStreak 与 stale 分别计数、分别告警,并给出「最近成功时间」供运维回溯。5.6 数据、历史与巡检报告
HMICare 的历史库为 SQLite(WAL 模式),默认位于 <exe目录>\var\hmicare.db;不可写时回落到 %ProgramData%\HMICare,并可用环境变量 HMICARE_DATA_DIR 覆盖。
| 数据类别 | 保留策略 | 用途 |
|---|---|---|
| 原始采样 | rawRetentionDays=7 天 | 实时趋势与历史回放 |
| 分钟聚合 / 事件 / 重启 | aggRetentionDays=180 天 | 长期趋势、事件追溯与验收统计 |
| 现场文件(转储/截图) | 按数量上限淘汰最旧(默认 120) | 事故分析 |
| 审计链 | var\audit\hmicare_audit.log | 防篡改操作留痕 |
5.6.1 巡检报告
菜单「文件 → 导出运行健康报告(HTML)」或 Ctrl+P 导出自包含 HTML 报告,覆盖十章内容:
5.6.2 历史库的分表设计
历史库为 SQLite 并启用 WAL 与 busy_timeout,允许「一写多读」——服务与界面可能同时打开同一个库。表结构按「采样 / 事件 / 维度 / 元数据」分类:
| 表 | 内容 | 写入频率 |
|---|---|---|
sample | 原始采样(进程级 + 服务器级 + 托管运行时) | 默认 2 s 一条 |
agg_min | 分钟聚合(avg / max) | 每分钟一条 |
event | 事件与告警(分级、分类、代码、说明、详情) | 按事件 |
restart | 重启记录(原因、新旧 PID、退出码、中断时长、转储与截图路径) | 按重启 |
storage / link / security / availability | 四维自省的分钟级聚合快照 | 每分钟一条 |
function | 关键功能健康检查明细(可回溯「当时哪一项在偷停」) | 按检查周期 |
audit | 看护自身审计记录(与文件哈希链互为佐证) | 按操作 |
meta | 作业时间戳与跨会话累计量(如可用率未观测时长) | 按周期 / 退出时补写 |
为什么新维度不追加到 sample 表:sample 使用位置绑定写入且已在现场部署,追加列会让老库上的写入整体错位;而且四维自省的采集频率与 2 s 采样不同,单独建表既能保持老库原地升级(新增表、不改既有表结构),也不需要为「每 2 秒一行」的存储成本买单。
保留策略:原始采样默认 7 天、聚合/事件/重启默认 180 天、四维快照与功能明细按深度保留天数滚动清理;审计表永不自动清理——删审计等于销毁证据,哈希链只保证「未被篡改」,不保证「未被删除」。
sqldrivers\qsqlite.dll 时,open() 返回失败,看护功能继续正常工作,只是不留历史记录,并在事件里明确提示。「看护不能因为记不了账就罢工」是一个刻意的取舍。5.7 配置、部署与运维
5.7.1 配置热更新
hmicare.ini 改动后不必重启服务:界面点「重载配置」(Ctrl+R)即热更新。hmicare.ini 或删掉对应那一行,重启即可。5.7.2 命令行
hmicare.exe                        打开界面;服务未运行时界面自带看护
hmicare.exe --console              前台守护,无界面,日志打到控制台
hmicare.exe --install [--start]    注册为系统服务(需管理员)
hmicare.exe --status               打印服务、看护角色、被监护进程与历史库状态
hmicare.exe --ui-selftest          界面自检(验收 / CI 用)
hmicare.exe --target <exe>         仅本次运行改用其它被监护程序
5.7.3 目录与文件
| 路径 | 内容 |
|---|---|
hmicare.ini | 配置文件(UTF-8,分节名/键名区分大小写) |
var\hmicare.db | 历史库(SQLite,WAL 模式) |
var\crash\ | 内存转储与画面截图,按数量上限淘汰最旧 |
var\audit\hmicare_audit.log | 防篡改审计链(每行含序号与 SHA-256 哈希链) |
var\log\ | 看护自身日志 |
var\watchdog.pid | 当前看护角色持有者 pid |
5.7.4 界面自检与像素级回归
看护器的界面是运维与它交互的唯一窗口,因此界面本身也需要被验证。平台提供两级自检,且都不需要人工点界面:
| 手段 | 用法 | 验证内容 |
|---|---|---|
| 数据链路自检 | hmicare.exe --ui-selftest(环境变量 HMICARE_SELFTEST_SEC 控制稳定时间 3~20 s) | 界面角色、控制通道、状态栏文案、各组趋势的曲线数与点数、告警/事件/重启表行数、历史库路径、看护器自身开销,以及运行自检页的数据来源、四张卡片文案与四张明细表实际行数 |
| 界面快照 | HMICARE_SELFTEST_SHOT=<目录> | 六个页签各存一张 PNG,另存一张整窗快照(唯一包含菜单栏/工具条/状态栏的快照) |
| 结构体检 | python tools\ui_snapshot_check.py shots overview deep | 等级色是否画出、卡片是否成排、仪表盘个数是否正确、工具条按钮图标是否补齐且大小均匀 |
| 指针反解 | python tools\gauge_needle_check.py shots\ui_overview.png overview 0.29:100 ... | 把自绘指针的角度折回量程,与同一次快照读到的数值逐个对照(偏差 < 1.5 个百分点为通过) |
为什么需要像素级回归:自检报告能证明「数据绑上了控件」,但仪表盘指针、等级色带、量值条是自绘的——报告里的数字对,不等于图上的画面对。这类缺陷在代码审查与单元测试里都看不见,只能靠「渲染 → 反解 → 比对」自动判定。
numpy 与 Pillow,只在装维/发版机器上运行,不进入现场部署包,不给运行环境增加任何依赖。自检为了验完链路会把被监护程序拉起来,退出时只关闭自己拉起的那个进程,现场本来就在运行的实例与服务看护的对象不会被碰。5.8 告警代码速查
告警代码是运维与看护之间的通用语言:看到代码就知道该查什么。代码按维度分组,下表摘录最需要现场处置的部分。
5.8.1 进程与内存
| 代码 | 级别 | 含义与处置 |
|---|---|---|
target-missing / target-self | Critical | 被监护程序不存在 / 目标配成了看护器自身。检查 [target] exe |
proc-hang | Critical | 连续无响应(窗口消息 / 心跳 / TCP 探活均超时) |
proc-mem-warn / proc-mem-crit | Warning / Critical | 进程物理内存越告警线 / 越重启线 |
proc-virt-warn / proc-virt-crit | Warning / Critical | 进程虚拟内存(提交)越告警线 / 越重启线 |
mem-leak | Critical | 最小二乘斜率判定为单向增长;结合历史回放斜率与 var\crash 转储定位 |
restart-thrash | Critical | 重启过于频繁,已进入风暴保护 |
watchdog-giveup | Fatal | 累计失败过多已放弃自动重启;修好环境后按 F8 复位 |
watchdog-footprint / watchdog-handle-growth | Critical / Warning | 看护器自身工作集超限 / 句柄单向增长——自愈能力可能静默失效,须尽快处理 |
5.8.2 磁盘、链路、安全与可用性
| 代码 | 级别 | 含义与处置 |
|---|---|---|
storage-db-stale | Warning | 历史库超过 N 分钟没有写入——静默停写的直接信号,数据正在丢 |
storage-volumes-warn / disk-crit | Warning / Critical | 有卷占用越告警线 / 越严重线(严重线即历史库停写线);先清陈旧文件,再考虑扩容 |
storage-io-warn / storage-io-crit | Warning / Critical | 卷读写延迟越 100 ms / 250 ms 线 |
link-diag-stale | Warning | 目标通道诊断快照停更——写入方可能已失效 |
link-device-offline / link-isolated | Critical | 离线设备数越严重线 / 有设备被隔离;查具体 PLC/RTU |
link-packet-loss / link-rtt / link-scan-lag | Warning | 链路劣化但未完全断:丢包、RTT 超限、采集跟不上 |
sec-clock-offset / sec-clock-jump | Warning / Critical | 对时偏差越限 / 本地时钟阶跃(会打乱 SOE 顺序);消息中会写明本机快或慢 |
sec-audit-broken | Critical | 审计哈希链断裂——按安全事件处理,保留现场并上报 |
avail-function-fail / avail-function-stale | Critical / Warning | 关键功能连续失败 / 数据陈旧:进程活着但功能已失效 |
watchdog-cpu | Warning | 看护器自身 CPU 长期偏高(只告警,不自动重启自己) |
5.9 安全边界与已知限制
| 不做 / 限制 | 原因 | 影响 |
|---|---|---|
| 不自动重启看护程序自己 | 避免「看护器重启看护器」把现场搞乱 | 自身异常只告警,需运维介入 |
| 默认不自动删除任何文件 | 删现场资料不可逆,必须显式开启 | 自动清理默认关闭,或手动触发 |
| 默认不启用进程白名单 | 现场软件构成复杂,先观测建立基线 | 避免误报 |
| 不碰外部服务 / 其它实例的对象 | 自检只收自己拉起的进程 | 不与第三方看护冲突 |
| 崩溃瞬间无法补抓转储 | Win32 硬限制 | 依赖 WER LocalDumps |
| Session 0 看不见交互桌面 | Windows 会话隔离 | 截图需用户会话助手,无人登录时跳过 |
| 单线程事件循环 | 无采样竞争与锁等待 | 慢盘上的大批量查询会拖慢采样 |
controlWorldAccess=0 使控制通道不跨会话暴露(界面退化为只读读库);启用进程白名单与信任目录;保持审计链开启并定期离线归档。5.10 与其它监控手段的技术对比
| 对比项 | 通用 IT 监控(Zabbix / Prometheus 类) | SCADA 自带诊断 | HMICare |
|---|---|---|---|
| 工业语义 | 以主机/端口/进程为主,不理解「通道 / 设备 / 质量码 / SOE」 | 理解通道与设备,但只覆盖采集 | 逐设备在线/离线/RTT/丢包 + 通道诊断快照消费 |
| 静默失效 | 难以判断「进程在但不干活」 | 部分覆盖采集链路 | 关键功能探针 + 数据新鲜度 + 历史库停写告警 |
| 自愈能力 | 通常只告警,不重启业务进程 | 一般不提供 | 崩溃/挂起/内存越限自动重启 + 现场保护 + 风暴保护 |
| 内存治理 | 看总量,不区分波动与泄漏 | 一般不提供 | 阈值主动保护 + 最小二乘斜率泄漏判定 |
| 审计与时钟 | 通用安全能力(需单独建设) | 操作审计为主 | 哈希链审计 + SNTP 偏差 + 时钟阶跃 + 只读消费操作审计 |
| 可用性口径 | 主机在线率,不等于业务可用率 | 一般不提供 | 业务连续运行时长 + 未观测剔除 + 关键功能健康率 |
| 部署形态 | 需部署服务端/Agent/数据库,架构重 | 随产品内置 | 单 exe 三形态(界面/服务/前台),SQLite 本地落库,零外部依赖 |
| 与采集的关系 | 旁路观测,不接触工业协议 | 直接读通道 | 只读消费运行站已写出的诊断快照,不侵入采集链路 |
HMICare 与通用 IT 监控不是替代关系:通用监控负责主机、网络与机房基础设施,HMICare 负责「SCADA 业务是否可用、采集链路是否健康、软件是否需要自愈」。两者可以通过「运维指标快照」与标准接口对接,形成完整的分层监控体系。
5.11 本章小结
HMICare 的设计目标可以概括为一句话:让 SCADA 系统的运行质量可观测、可自愈、可追溯、可交付。可观测——进程、服务器、磁盘、链路、安全、可用性六个面全部有指标与告警;可自愈——崩溃、挂起、内存越限自动拉起,并带现场保护与风暴保护;可追溯——事件、重启、审计、可用性全部落库并导出巡检报告;可交付——单文件部署、配置热更新、报告自包含,运维无需专业工具即可上手。