HMIPlayer 是平台的运行引擎,也是技术含量最集中的部分。它同时承担采集、实时数据服务、历史归档、报警评估、画面渲染、对外数据服务与冗余协同七类职责。本章按「架构 → 实时库 → 历史库 → 百万测点 → 报警 → 驱动 → 组网 → 3D → 大规模策略 → 指标汇总」的顺序展开,并给出与专业 SCADA 的对比。
3.1 运行时架构与线程模型
运行站的性能瓶颈通常不在 CPU,而在阻塞:一个同步的历史查询、一次阻塞的协议读写,就能让整个画面卡住。因此 Player 的线程模型以「I/O 与 UI 彻底隔离、重活走线程池」为原则。
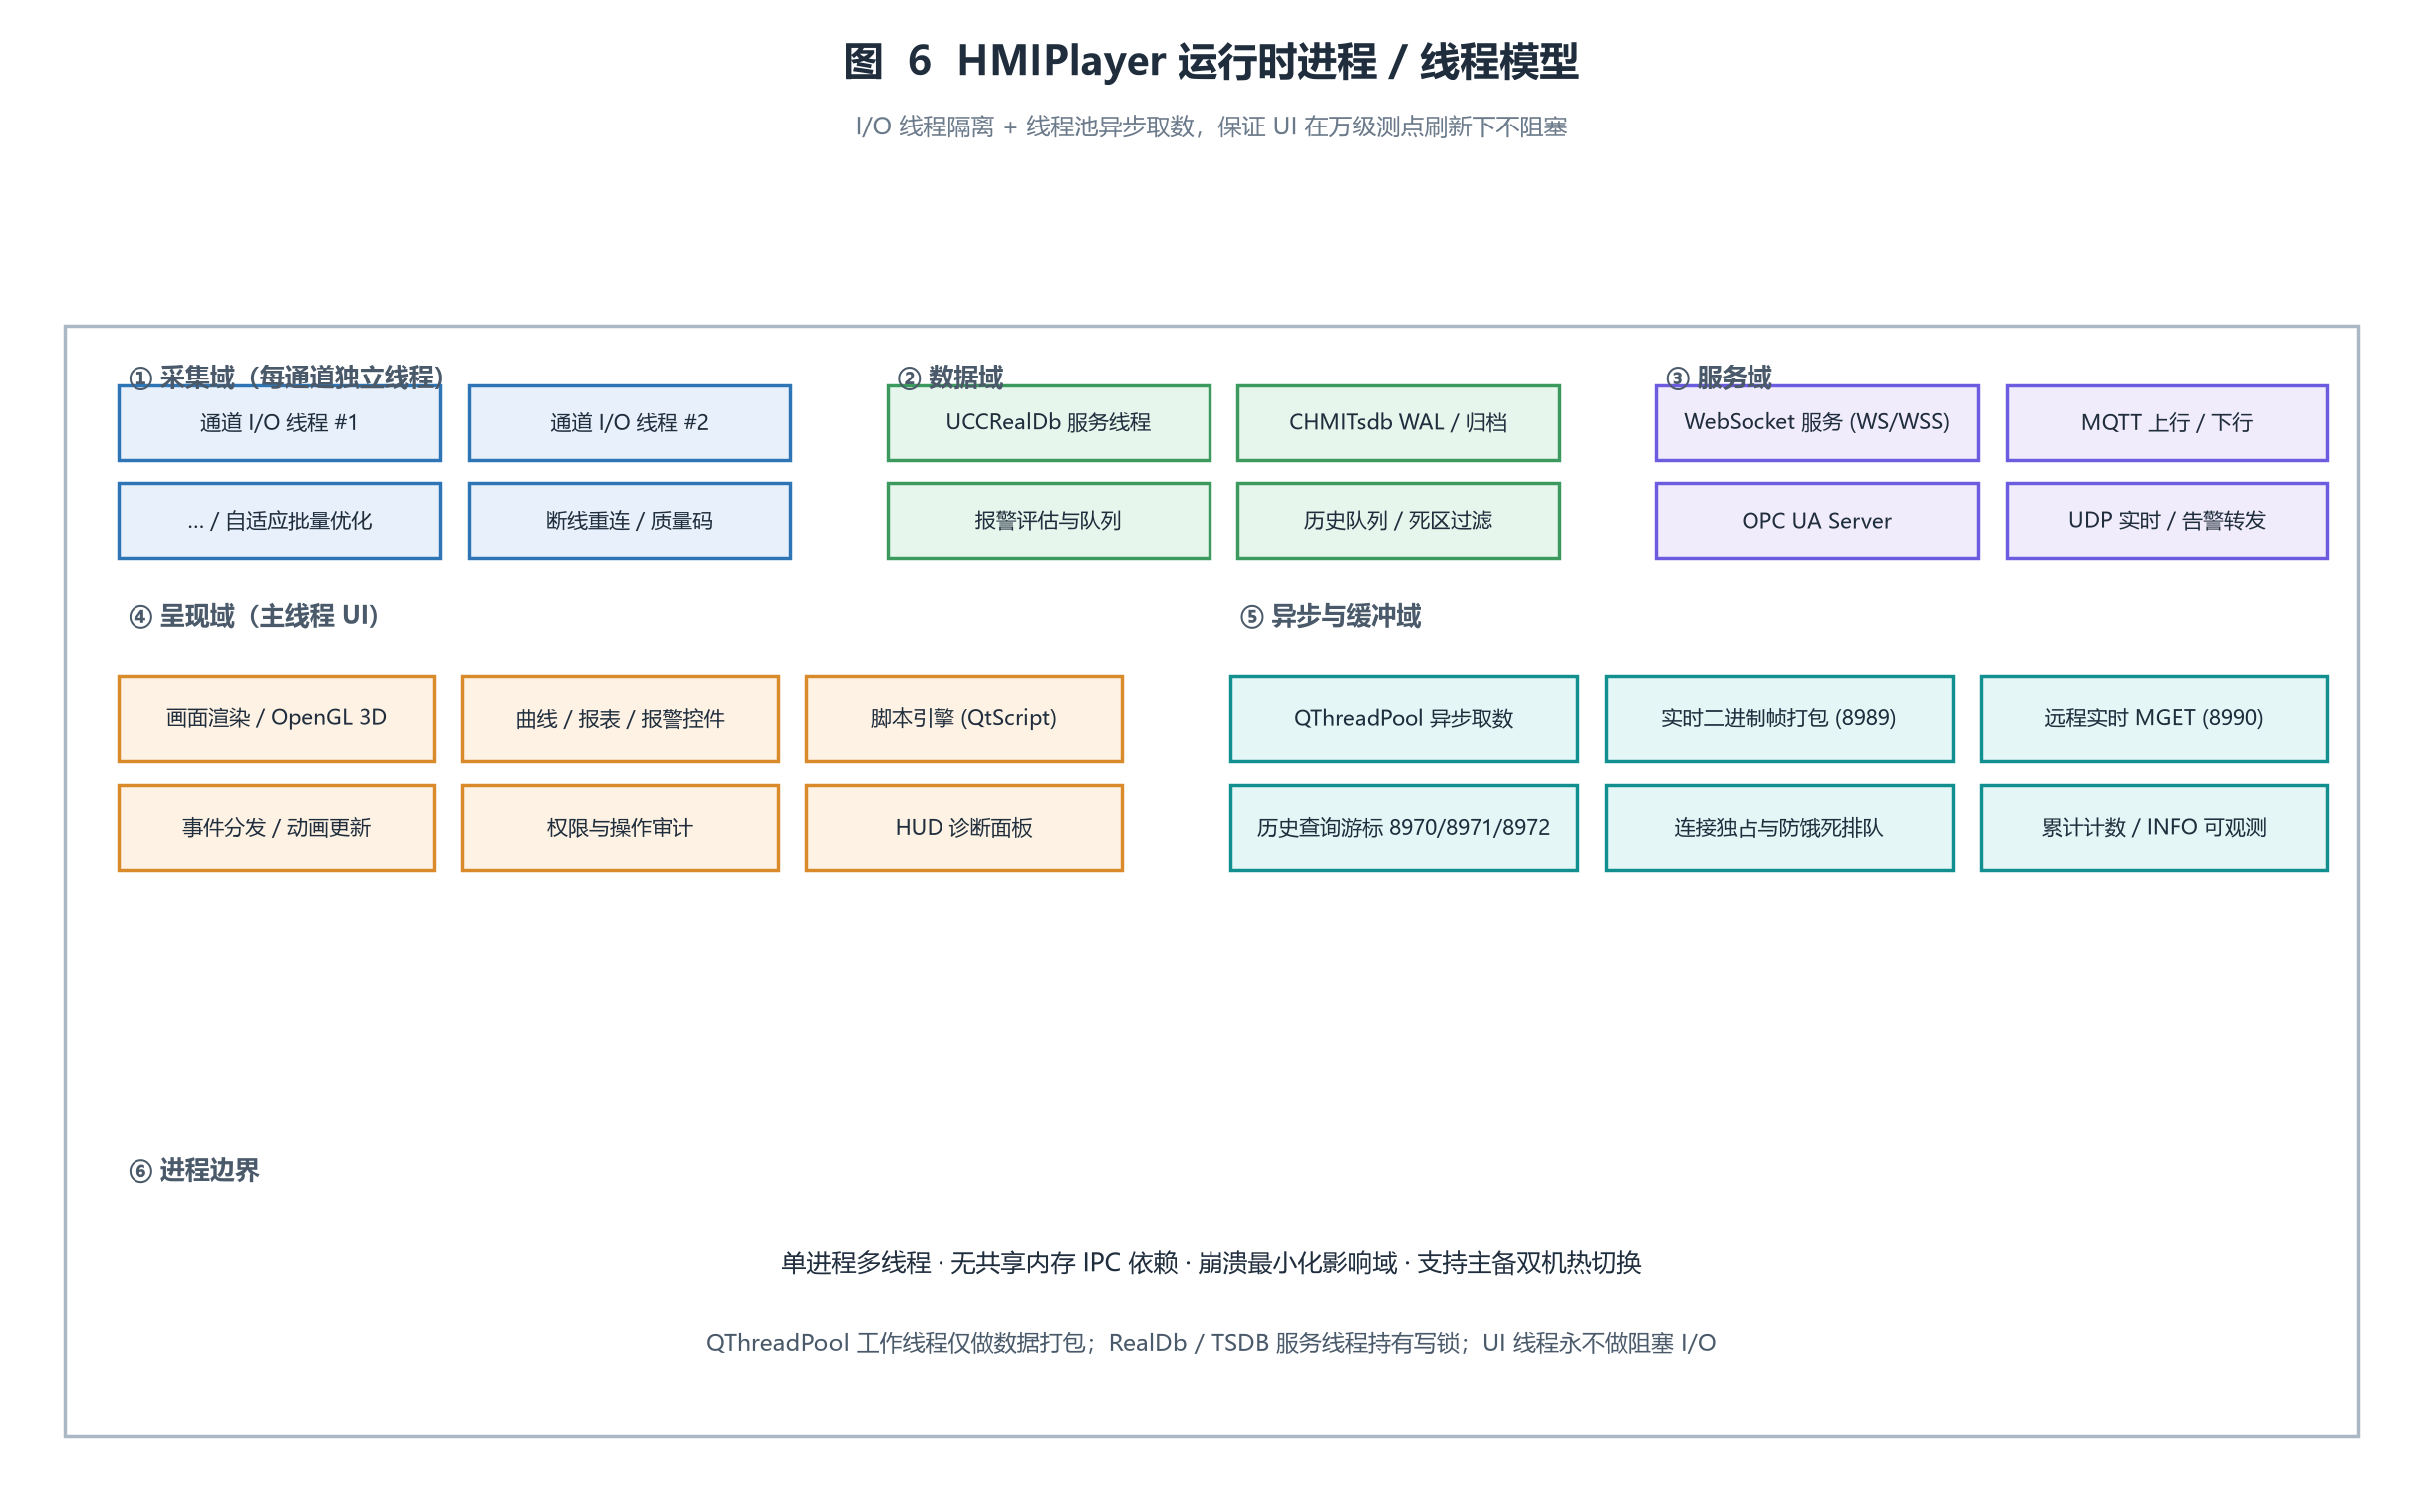 图 6 HMIPlayer 运行时进程 / 线程模型
| 域 | 组成 | 设计要点 |
|---|
| ① 采集域 | 每个通信通道一个独立 I/O 线程;自适应批量优化;断线重连与质量码 | 任一通道阻塞不影响其它通道,也不影响 UI |
| ② 数据域 | 实时库服务线程、时序库 WAL/归档线程、报警评估与队列、历史队列与死区过滤 | 写路径分级(P0/P1/P2),关键写不被非关键写拖慢 |
| ③ 服务域 | WebSocket 服务、MQTT、OPC UA Server、UDP 实时与告警转发 | 对外服务与内部采集解耦,客户端数量不影响采集周期 |
| ④ 呈现域 | 主线程 UI:画面渲染、OpenGL 3D、曲线报表报警控件、脚本引擎、事件分发、权限审计、HUD 面板 | UI 线程不做任何阻塞 I/O;重活一律异步 + 回调 |
| ⑤ 异步缓冲域 | 线程池异步取数(本地/远程实时库)、实时紧凑二进制打包、远程 MGET、历史查询游标、连接独占与防饿死排队、累计计数与可观测 | 每个客户端连接独占一次取数,避免慢客户端拖垮共享队列 |
注防饿死设计:当某个客户端连接正在取数时,其它请求不排队等待,而是保留「每连接最新一次实时轮询」(紧凑二进制帧优先于 JSON 帧),在锁释放后立即投递最新结果。这样既避免了请求堆积,也保证了数据新鲜度。
3.2 实时库 UCCRealDb
UCCRealDb 是运行站的实时数据核心。它的定位是「面向工业现场的、命令语义与 Redis 兼容的进程内内存数据库」——既可作为进程内 API 被画面与脚本直接访问,也可作为独立服务被外部客户端(WebPlayer、第三方系统、运维工具)读写与订阅。
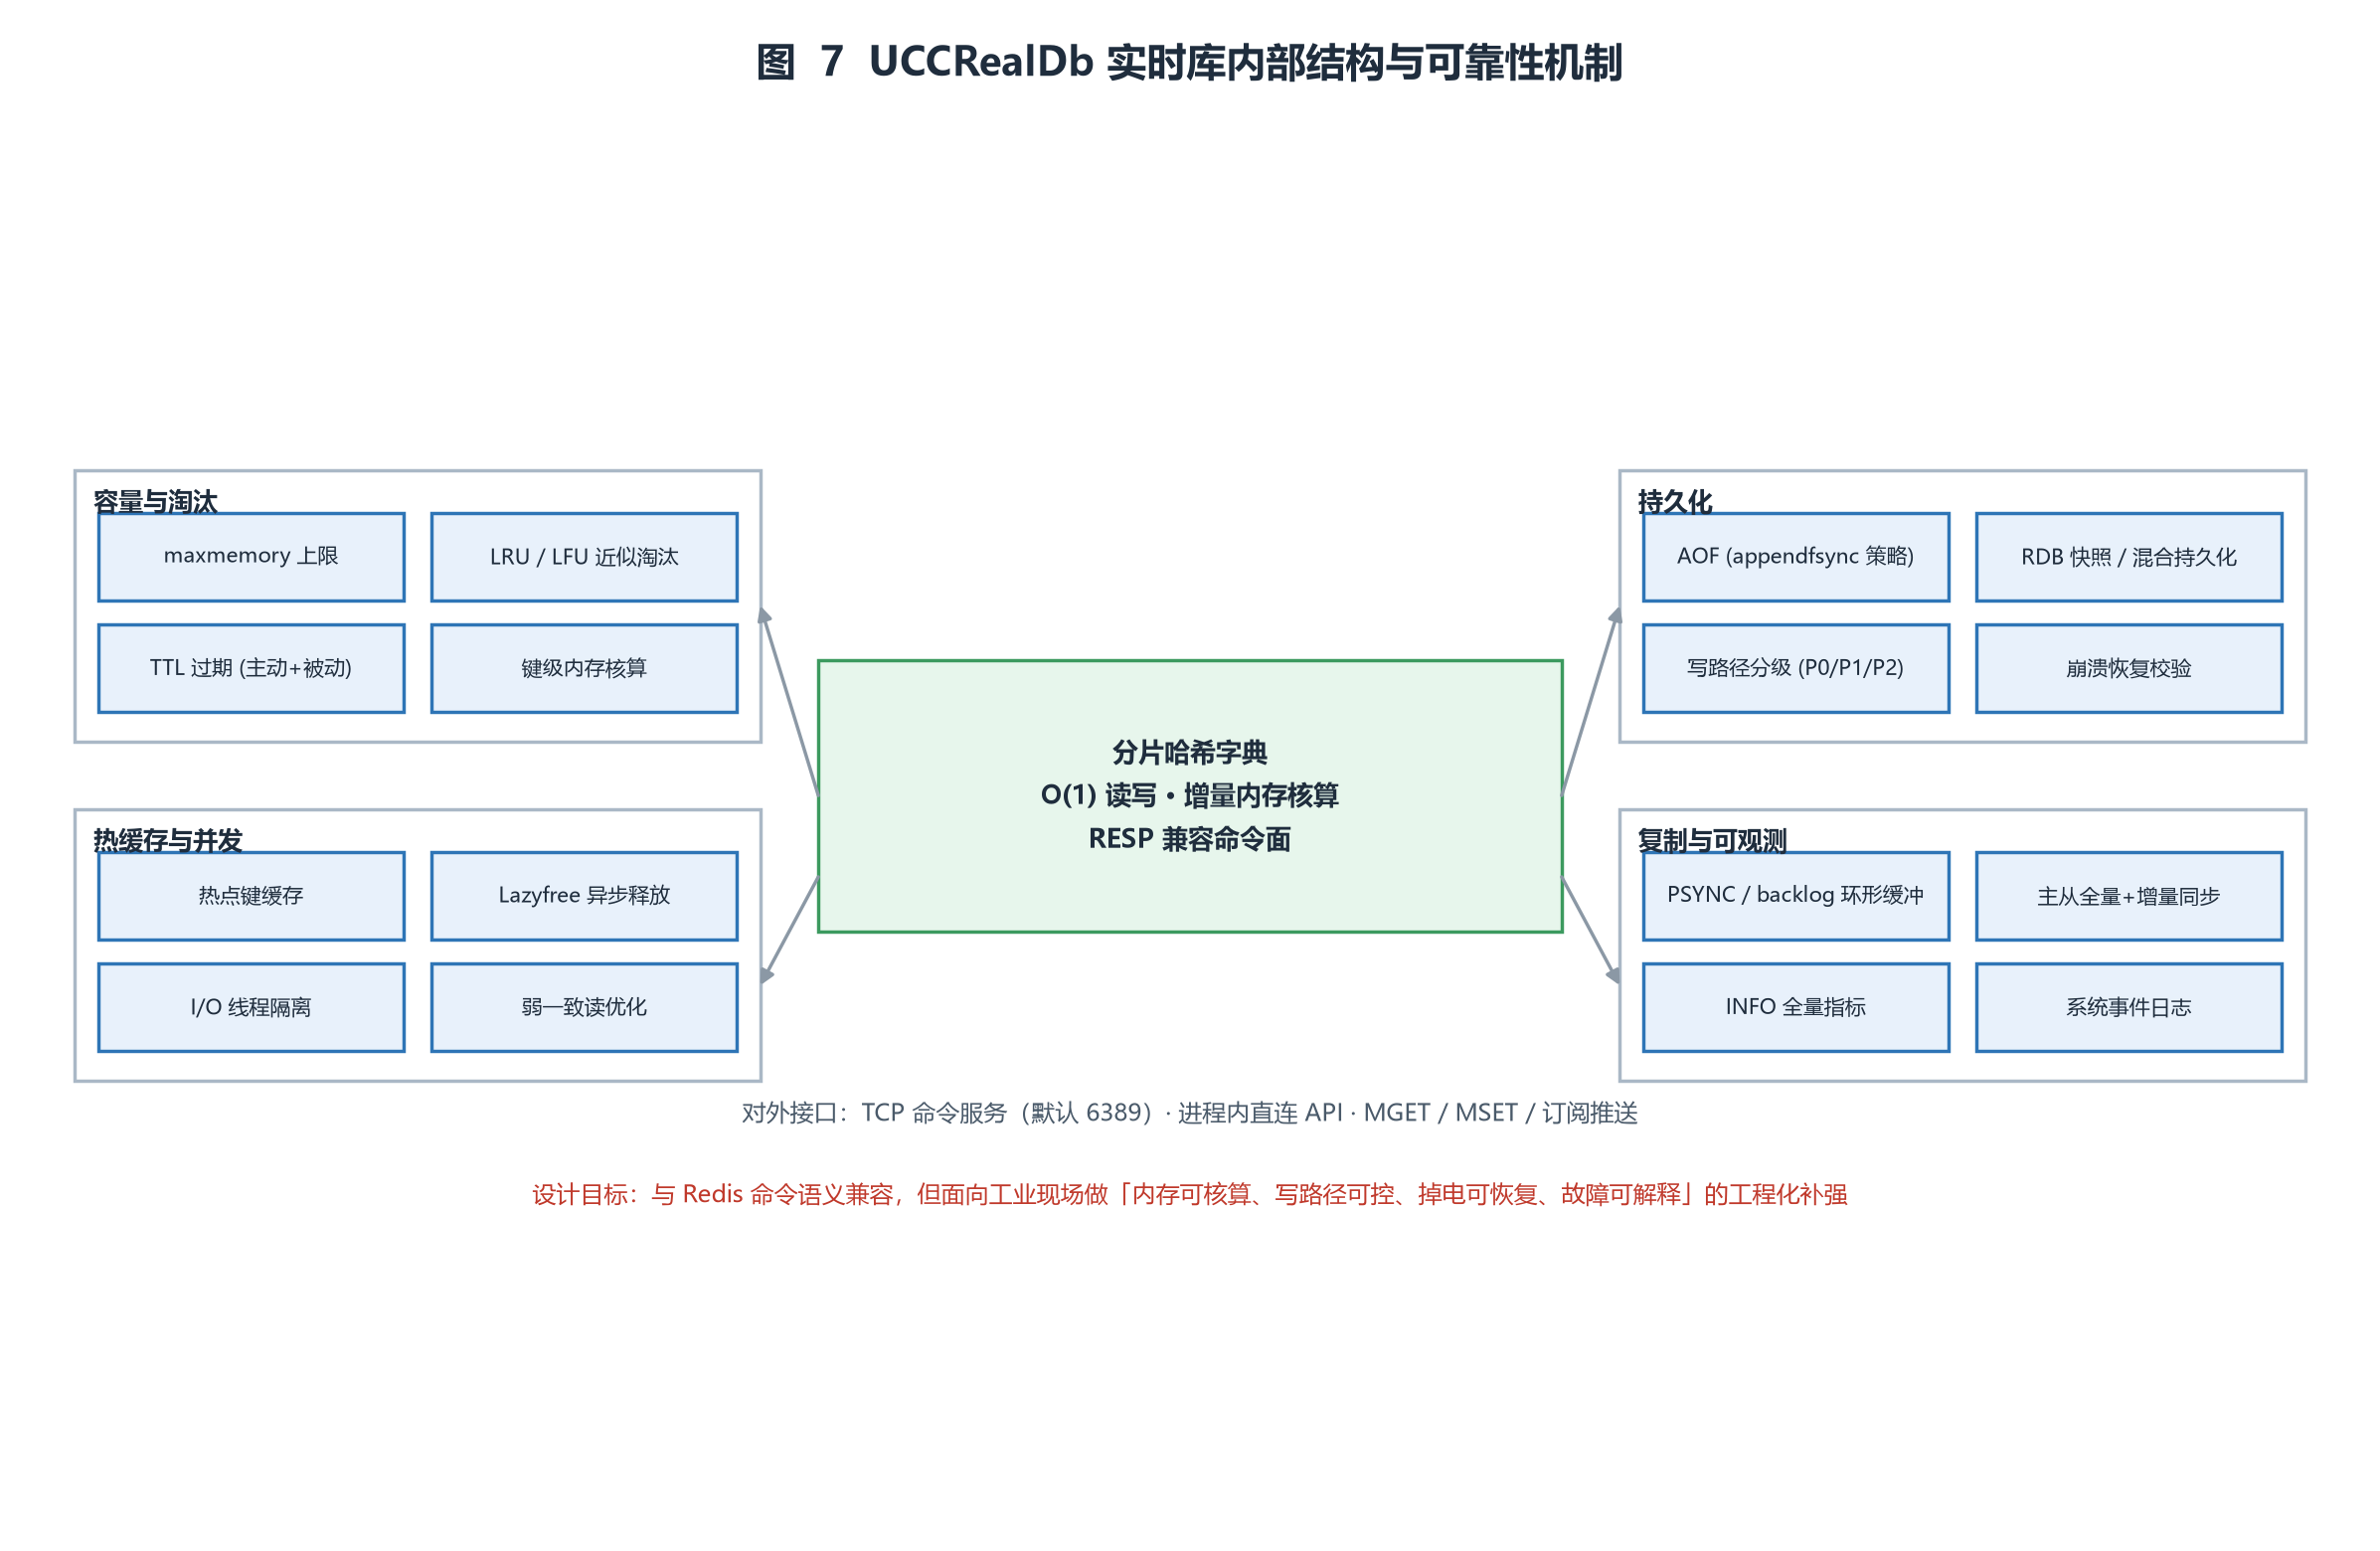 图 7 UCCRealDb 实时库内部结构与可靠性机制
3.2.1 接口与命令面
| 接口 | 说明 |
|---|
| 进程内 API | 运行站内部直接调用,零拷贝路径,用于画面刷新与脚本访问 |
| TCP 命令服务 | 默认端口 6389,RESP 协议兼容,支持标准客户端与自研工具接入 |
| 命令集 | 字符串/哈希/列表/有序集合等数据结构 + 过期、扫描、订阅相关命令 |
| 运维控制台 | ucchmiserver 侧提供可视化控制台,可查看键空间、执行命令、查看 INFO 与容量状态 |
| 集群/复制命令 | 支持节点间复制与集群通告(cluster 相关命令) |
3.2.2 内存核算与容量治理
实时库最典型的故障模式是「内存缓慢上涨直至 OOM」。为此,UCCRealDb 建立了从键级到全局的完整核算体系:
键级内存核算:每个键记录自身占用的字节数(含开销),全局维护增量合计,避免每次统计都做全量遍历。
容量硬上限:maxmemory / maxTotalEntries 明确上限,超出时按策略淘汰或拒绝写入。
淘汰策略:近似 LRU / LFU,扫描键数上限可配置,按容量占用率动态调整扫描强度。
过期策略:主动过期(分片轮询,带密度与命中率统计)+ 被动过期(访问时判定)。
背压与拒绝:暴露 oom_rejected_writes_total、backpressure_rejected_writes_total、write_backpressure_{level_pct,pending,capacity},让「写不进去」这件事变得可观测、可告警。
注写路径分级是工业场景的关键设计:现场级的关键写入(如操作员下发、报警确认)走 P0 路径,监控级写入走 P2 路径。当容量接近上限时,系统优先拒绝低优先级写入,而不是让所有写入一起变慢甚至丢失。
3.2.3 热点与并发优化
| 机制 | 解决的问题 | 效果 |
|---|
| 分片哈希键映射优化 | 键分布偏斜导致部分分片过载、部分空闲 | 改为乘法散列取高位后,分片负载比 max/mean 从 1.94 降至 1.01;容量可用率 71.6% → 99.9% |
| 逐出选牺牲者优化 | 容量贴近上限时,每次写都要扫描分片找牺牲者,写路径严重退化 | 常驻牺牲者池 + 有界游标,逐出开销从约 1.2 ms/次降到 10.1 μs/次,且与分片规模解耦 |
| 异步惰性释放 (lazyfree) | 删除大对象时阻塞主路径 | 大对象释放移出关键路径,降低长尾延迟 |
| I/O 与数据线程隔离 | 网络 I/O 与数据操作争抢锁 | 采集/服务互不阻塞,锁竞争显著下降 |
| 热点缓存 | 高频键反复计算与查找 | 热点键常驻缓存,读路径进一步缩短 |
3.2.4 持久化
| 机制 | 说明 | 适用场景 |
|---|
| AOF | 追加日志 + appendfsync 策略分级(always / everysec / no) | 对数据完整性要求高的实时状态与配置量 |
| RDB 快照 | 周期性全量快照,支持压缩 | 快速恢复与备份 |
| 混合持久化 | 快照 + 增量日志结合,兼顾恢复速度与完整性 | 生产环境推荐 |
| 崩溃恢复校验 | 加载时校验结构与计数一致性,异常时拒绝加载并告警 | 避免「带病启动」导致的数据错乱 |
3.2.5 复制与冗余
PSYNC 语义的增量复制:主从首次同步走全量,后续走增量,配合环形 backlog 缓冲,避免短时断链触发全量重传。
环形 backlog:容量可配置,用于断线重连后的增量补齐。
主从状态可观测:复制偏移、连接状态、同步进度通过 INFO 暴露。
与运行站冗余协同:实时库主从关系与运行站主备关系一致,切换时数据不出现回退。
3.2.6 可观测性
实时库实现了与 Redis 语义对齐的 INFO 命令,并按段落组织:
| INFO 段落 | 覆盖指标 |
|---|
| server / clients | 版本、运行时长、连接数、客户端信息 |
| memory | maxmemory 系列、已用内存、内存占比、回收统计 |
| stats | 累计命令数、读写命令分别计数、过期键数、淘汰键数、命中率(keyspace_hits/misses)、instantaneous_ops_per_sec 及读写分量 |
| keyspace | 各分片/前缀的键数量与过期键数量 |
| persistence | AOF/RDB 状态、最近一次快照/重写信息、失败计数 |
| replication | 角色、主从地址、复制偏移、backlog 状态 |
| expire | 主动过期扫描的密度、命中率、移除总数、时间上限触发次数 |
| rejections | OOM 拒绝写入总数、背压拒绝写入总数、背压等级/待处理量/容量 |
注instantaneous_ops_per_sec 由命令服务自身的 1 秒定时器做自驱动差分,语义与 Redis 一致——是瞬时值(最近 1 秒),而不是开机以来的平均值。这一区别对诊断「周期性卡顿」至关重要。
3.2.7 实测性能数据
下表摘自项目内归档的 TCP 压测样本(bench_c*.csv,固定 n=6000、无 pipeline、单机测试)。
表 3-1 实时库 TCP 压测样本(并发 1,value 32 B)
| 操作 | ops | 耗时 (s) | 吞吐 (ops/s) | p50 (μs) | p95 (μs) |
|---|
| SET | 6000 | 1.0425 | 5 756 | 158.4 | 226.0 |
| GET | 6000 | 0.7174 | 8 363 | 108.9 | 162.8 |
| DEL | 6000 | 1.0411 | 5 763 | 159.5 | 221.9 |
| HSET | 3000 | 0.5358 | 5 599 | 162.3 | 226.2 |
| RPUSH | 3000 | 0.5334 | 5 624 | 161.9 | 224.5 |
| ZADD | 6000 | 2.7854 | 2 154 | 445.2 | 561.1 |
表 3-2 实时库并发扩展性(GET,value 32 B)
| 并发度 | 吞吐 (ops/s) | p50 (μs) | p95 (μs) |
|---|
| 1 | 8 363 | 108.9 | 162.8 |
| 4 | 13 561 | 268.2 | 432.9 |
| 8 | 15 972 | 464.7 | 734.8 |
并发从 1 提升到 8 时,聚合吞吐提升约 1.9 倍,同时单请求 p50 延迟上升约 4.3 倍——这是锁竞争与排队的正常表现,说明系统在「高吞吐」与「低延迟」之间存在可预期的权衡曲线,而不是出现非线性劣化。
表 3-3 关键优化项的实测效果(单变量对比)
| 优化项 | 优化前 | 优化后 | 提升 |
|---|
| 分片键映射(乘法散列取高位) | SET 吞吐 13.6k ops/s;容量可用率 71.6% | 151.5k ops/s(6.6 μs/op);可用率 99.9% | 吞吐 11.1× |
| 逐出选牺牲者(常驻池 + 有界游标) | 约 1.2 ms/次(sz≈3125) | 10.1 μs/次,与分片规模解耦 | 约 119× |
| 写路径退化(贴容量上限运行) | 5.5 μs/op → 约 220 μs/op | 仅在真正达到全局容量时才触发逐出 | 消除稳态退化 |
注上述优化过程是单变量矩阵验证的:例如通过 maxTotal=0(关闭容量上限)与默认 maxTotal=200000 的对照,证明了写路径阶梯退化的真因是「默认逐出策略 + 分片散列偏斜」,而不是内存记账本身。这类可复现的定位过程,正是「数据可核算」设计哲学带来的直接收益。
3.3 历史库 CHMITsdb
历史库要同时满足三个互相冲突的诉求:写入不丢、占用可控、查询够快。CHMITsdb 的做法是把三者拆到不同的机制上解决。
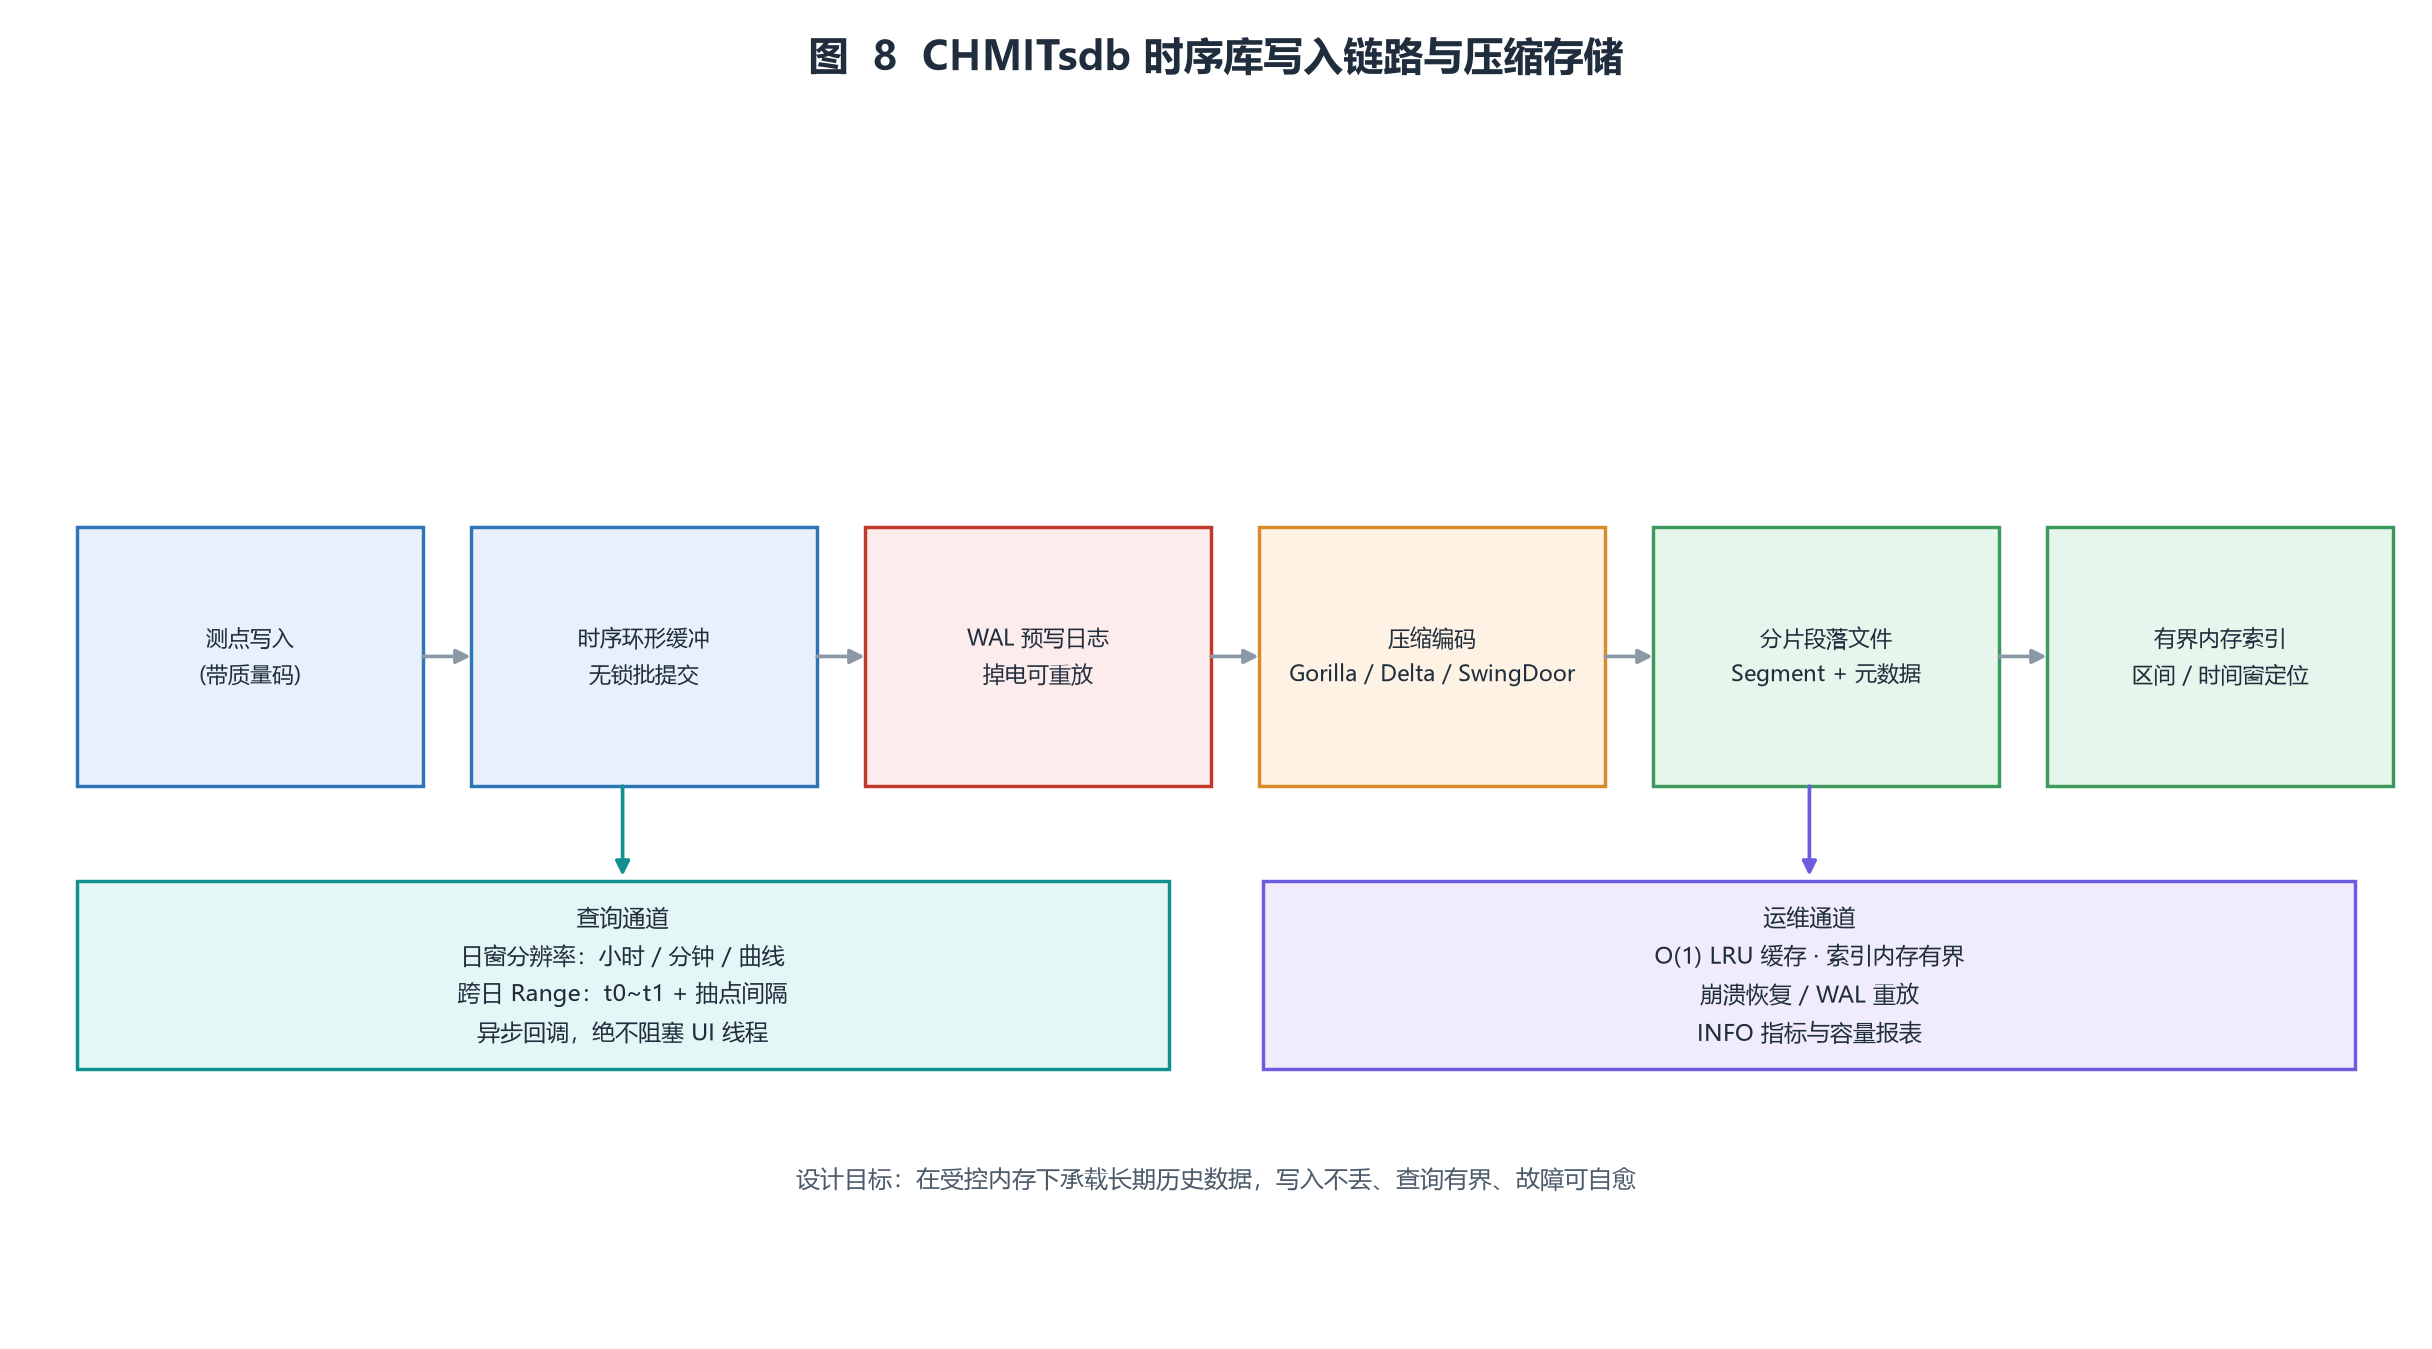 图 8 CHMITsdb 时序库写入链路与压缩存储
3.3.1 写入链路与掉电保护
| 环节 | 机制 | 目的 |
|---|
| 测点写入 | 带质量码与时间戳写入,支持乱序(OOO)与重复样本判定 | 保证现场数据的真实性与可追溯性 |
| 环形缓冲 | 批量提交、无锁/低锁设计 | 吸收突发写入,避免阻塞采集线程 |
| WAL 预写日志 | 先写日志再写数据,掉电后可重放 | 解决「掉电丢失最近若干分钟数据」的经典问题 |
| 压缩编码 | Gorilla / Delta / SwingDoor 三种编码,按块选优 | 在保精度前提下大幅降低存储占用 |
| 分片段落 | 按时间/容量切分段落文件 + 元数据 | 避免单文件无限增长,便于归档与冷热分离 |
| 有界内存索引 | 索引常驻内存但受容量约束,过期索引可回收 | 解决「历史点越多内存越涨」的问题 |
3.3.2 压缩与可观测
压缩采用「按块多编码试算取优」的策略:对同一数据块分别用 Gorilla、Delta、SwingDoor 编码,选取体积最小的结果,并记录原始字节数与编码后字节数,从而可以对外提供压缩比这一关键运维指标。
压缩比可观测:raw_bytes_ingested / encoded_bytes_written 按固定口径统计。
KPI 卡片:写入速率(样本/秒,取两次刷新增量)、样本/块、归档测点数量、磁盘占用、压缩比、查询延迟。
健康阈值:WAL 落盘失败 → 红色;WAL 超过 512 MB → 琥珀色告警。
3.3.3 查询能力
| 查询类型 | 参数 | 说明 |
|---|
| 日窗曲线 | 分辨率:小时 / 分钟 / 曲线;起止时刻;最大点数 | 典型的历史趋势回放,按窗口粒度预聚合 |
| 跨日区间 | t0~t1 毫秒时间戳、最大点数、抽点间隔 | 任意时间段的数据提取与报表计算 |
| 报警历史分页 | 时间范围、确认状态、最低等级、报警组、区域、点名模糊匹配、页码与页大小 | 报警查询与统计,支持分页避免一次性拉取过多数据 |
| SOE 事件 | 按日 + 关键字 + 最大条数 | 事件顺序记录查询,用于事故分析 |
注Web 端的强制异步:WebPlayer 中的历史查询必须走异步回调路径,禁止嵌套事件循环(QEventLoop),否则会在 WASM 环境中卡死或崩溃。查询支持游标取消,超时或发起新查询时取消网关游标,避免「过期结果覆盖新结果」的数据错乱。
3.4 百万测点组态 CHMIMegaConfig
「百万测点」在组态软件中不只是一个数字,而是一组具体的工程难题:注册表内存占用、建点速度、查询速度、热数据写入速度、重复字符串的存储开销、以及长期运行的内存漂移。CHMIMegaConfig 通过「分段配置池 + 冷字符串去重池 + 有界内存索引」三件套解决这些问题。
3.4.1 架构要点
| 构件 | 作用 | 设计要点 |
|---|
| 配置池(分段) | 存放测点主属性记录 | 固定容量段(最大 250 000 条/段),段池按需增长(8 192 起,2× 扩容至 250 000) |
| 热池 | 存放高频访问的附加属性 | 以小结构存放,提升缓存命中 |
| 冷字符串池 | 去重存放描述、单位等字符串 | 下标 0 恒为空串哨兵,避免语义二义;支持显式压缩回收 |
| 索引 | ID 表 / 名称哈希 / 设备倒排 | 有界内存;名称哈希采用主桶 + 碰撞桶,查找按真实名称确认 |
| 持久化 | 段文件 + SQLite | 落盘为分段二进制 + 关系表,支持快速重载与抽样校验 |
3.4.2 实测数据
表 3-4 CHMIMegaConfig 综合实测(--scale=4,1 426 002 测点)
| 指标 | 数值 |
|---|
| 测点数量 | 1 426 002 |
| 进程 RSS | 577.7 MiB |
| 注册表记账合计 | 504.4 MiB |
| ├ 配置池(容量口径,128 B/点) | 244.1 MiB |
| ├ 热池(容量口径,12 B/点) | 22.9 MiB |
| ├ 冷字符串池(实测分配) | 93.3 MiB |
| └ 索引(ID 表 / 名称哈希 / 设备倒排) | 144.0 MiB |
有效测点实占 memory_used_bytes | 140 B/点(190.4 MiB) |
| 冷池去重条目 | 1 636 096(5 个池合计,已扣除空串哨兵) |
| 长稳稳态 RSS 漂移 | 0.230%(1.12 M 次读写混合后) |
| 保存耗时(段文件 + SQLite,1 426 002 行) | 20 471 ms |
| 重载耗时(优先 SQLite) | 17 765 ms |
| 落盘体积 | 436.39 MiB(320.9 B/点) |
| 单次冷池压缩回收 | 18.28 MiB(3.09 s,一次性维护动作) |
| 抽样属性比对一致性 | 0 / 500 不一致 |
注容量规划口径:有效数据按 140 B/点 计算;另需按经验预留「冷池 + 索引」约 170 B/点。即百万点工程的注册表常驻内存建议预算为约 300~350 MiB,另加运行时开销。未打开的段不占内存。
表 3-5 组态访问性能(--scale=4)
| 操作 | 单次耗时 | 折算吞吐 |
|---|
findById(按 ID 命中) | 148 ns | 6.76 M/s |
findByName(按名命中) | 680 ns | 1.47 M/s |
findByName(未命中) | 477 ns | 2.10 M/s |
writeHotBatchById(批量热写) | 45.6 ns/点 | 21.9 M/s |
8 线程并发 readHotById | 234 ns/点 | 4.27 M/s |
3.4.3 一致性与鲁棒性
| 测试项 | 结果 |
|---|
| 8 线程混合建点 56 000 点 | 重复 tag_id = 0 |
| 抽样索引一致性(id ←→ 名称 ←→ 位置) | 0 / 20 000 不一致 |
| 混合读取命中率 | 100% |
| CRC / 魔数自检 | 通过 |
| 名称哈希碰撞(真实构造 FNV-1a 碰撞对) | 1.43 M 名称量级累计 9 次碰撞,两个测点均可按名寻址,属性回读一致 |
注名称哈希碰撞是百万点规模下必然出现的问题(按 n^2/2^33 估算,1.43 M 名称期望约 0.24 次,实测 9 次属正常波动)。原实现采用单桶直接覆盖,会导致被测点「只剩 ID 可达、按名永久查不到」;现实现采用主桶 + 碰撞桶并按键入名称二次确认,从机制上消除了这一类静默错误。
3.5 报警与 SOE
报警子系统的设计目标是「不放过真实报警,不制造无效报警」,并保证全过程可追溯。
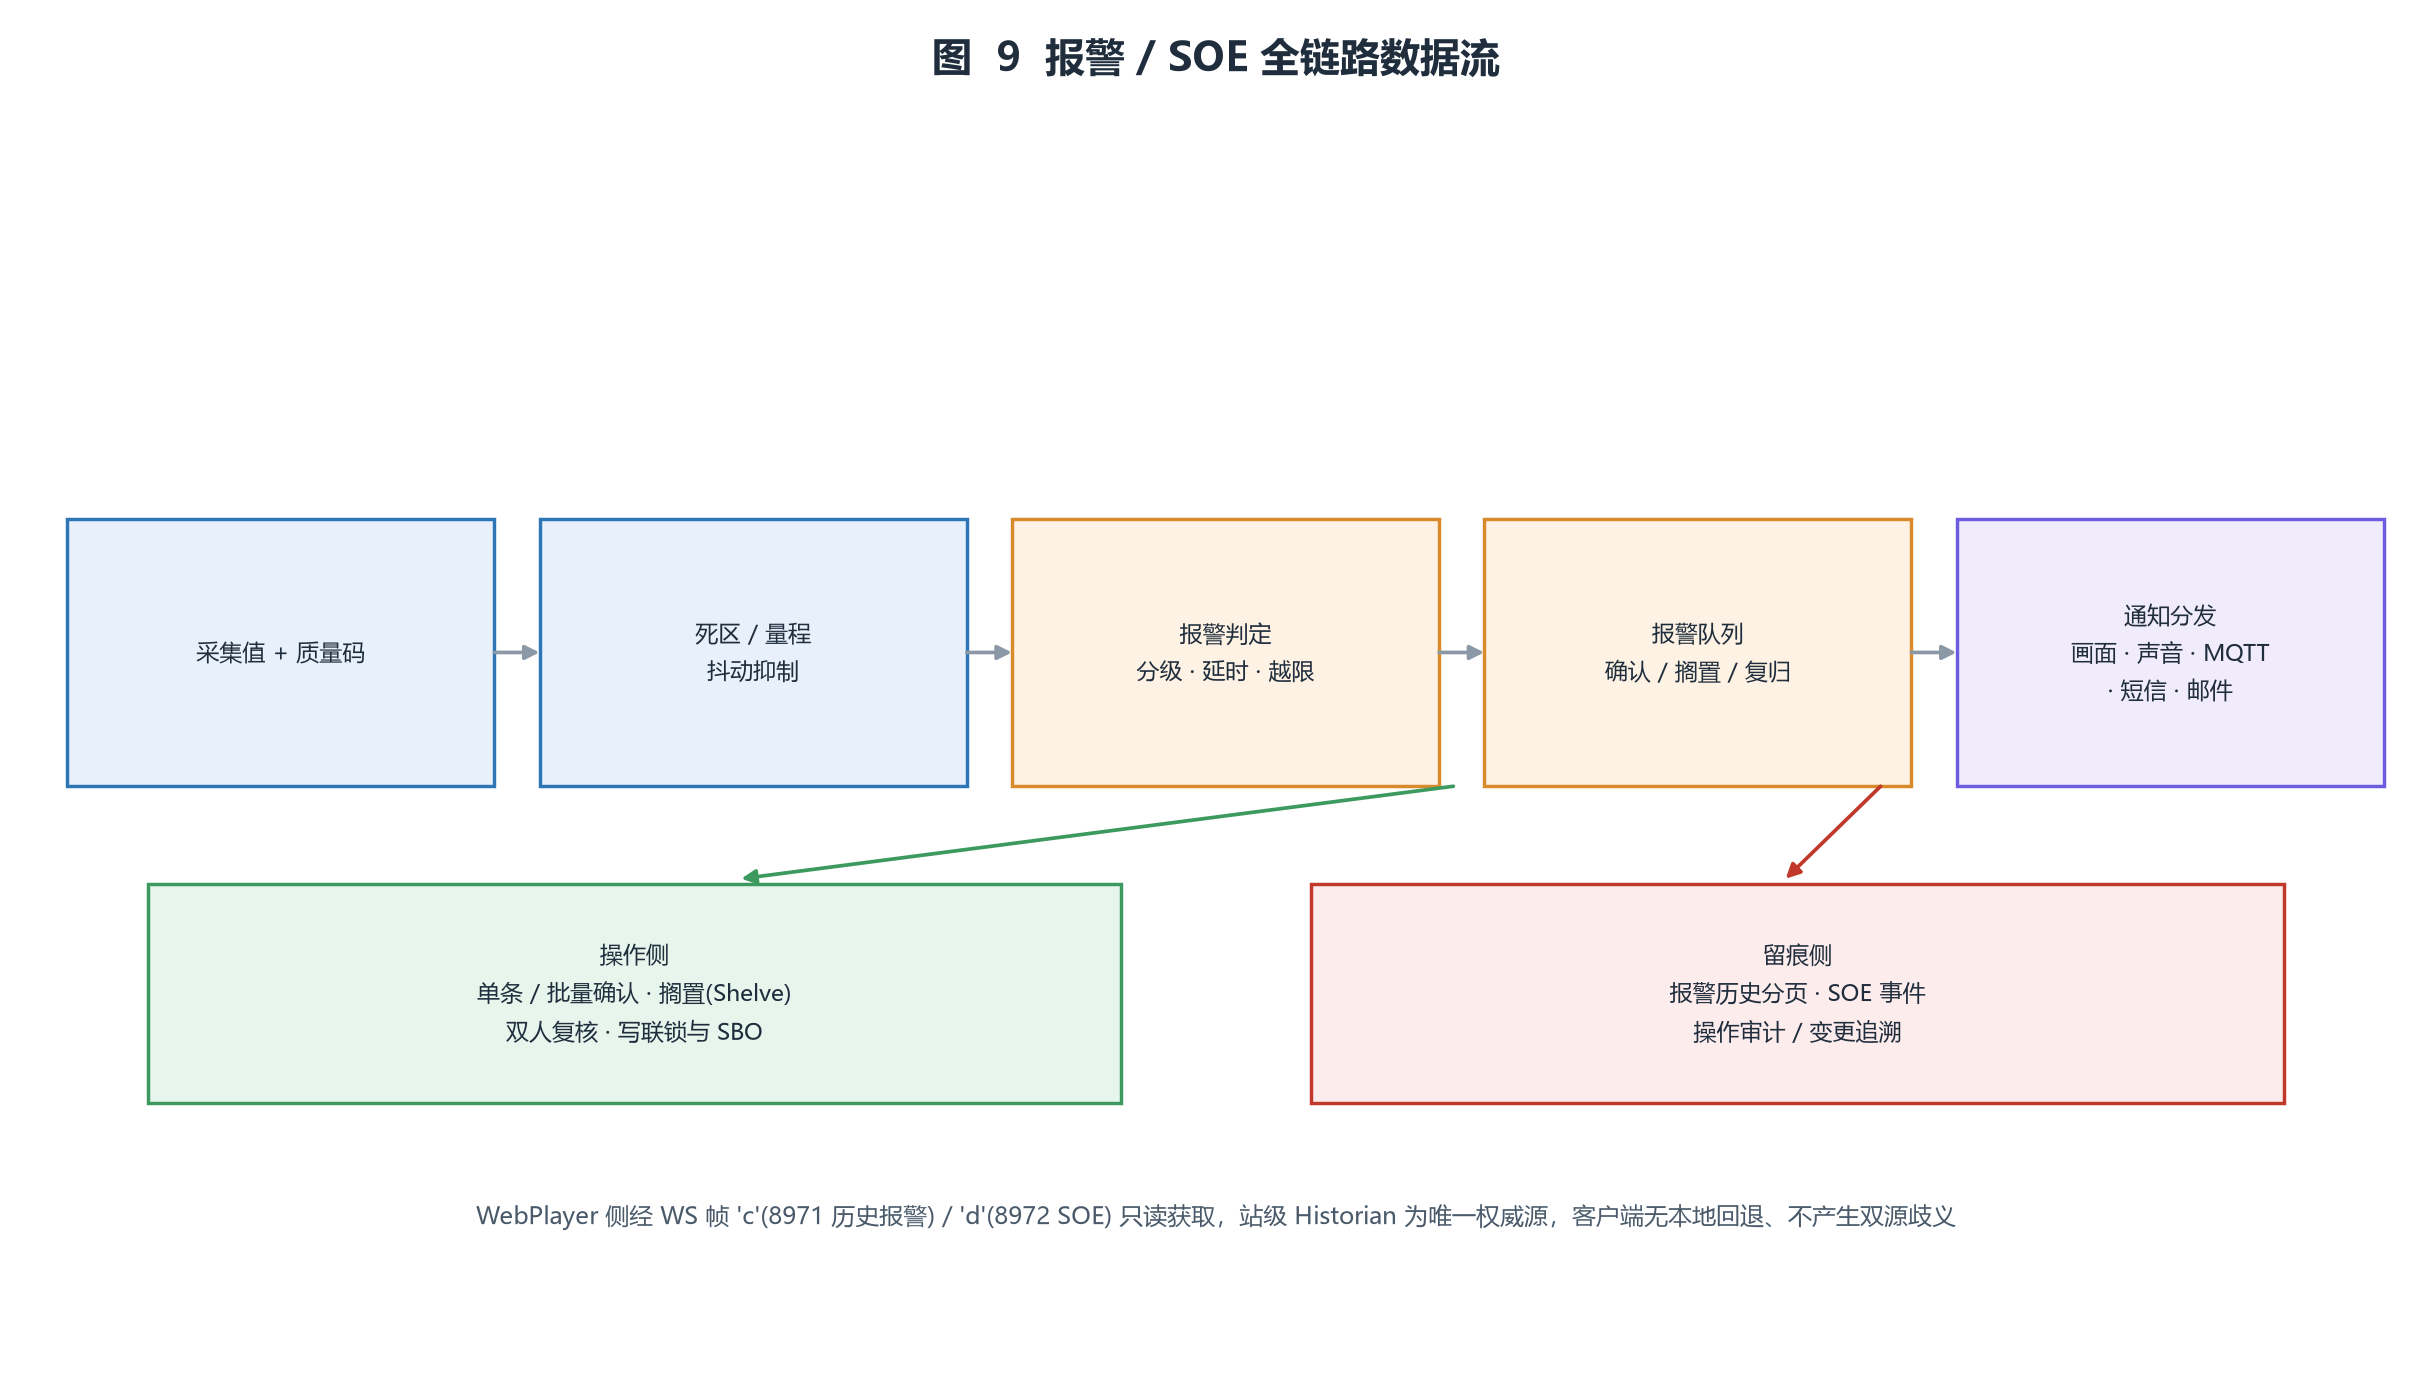 图 9 报警 / SOE 全链路数据流
| 阶段 | 能力 |
|---|
| 判定 | 越限、变化率、偏差、开关量变位、设备通信中断等;支持分级(如紧急/重要/次要/提示)、延时确认、抖动次数抑制 |
| 队列 | 报警队列容量可配置(桌面 8 000 / Web 64),溢出策略明确并可观测,不静默丢弃 |
| 通知 | 画面报警条与报警表、声音、MQTT 推送、短信/邮件(可扩展) |
| 确认操作 | 单条确认、批量确认、搁置(Shelve)、全确认、重同步;关键操作支持双人复核 |
| 留痕 | 报警历史(可分页查询、按等级/区域/点名过滤)+ SOE 事件顺序记录,记录到毫秒级时间戳 |
| KPI | 对标 ISA-18.2 的报警 KPI:报警率、峰值率、抖动率、待确认数量、确认及时率 |
注Web 端的报警操作:WebPlayer 通过网关转发站级命令(事件上报、确认、全确认、重同步、搁置等),由站端统一执行与留痕,浏览器端不产生独立的报警权威数据。
3.6 通信驱动体系
驱动是组态软件与现场之间的唯一通道,也是「能不能接进来」的决定性因素。平台采用统一驱动框架 + 协议族实现的结构:所有协议共享同一套设备/数据块/命令抽象,从而共享优化、诊断与质量码处理逻辑。
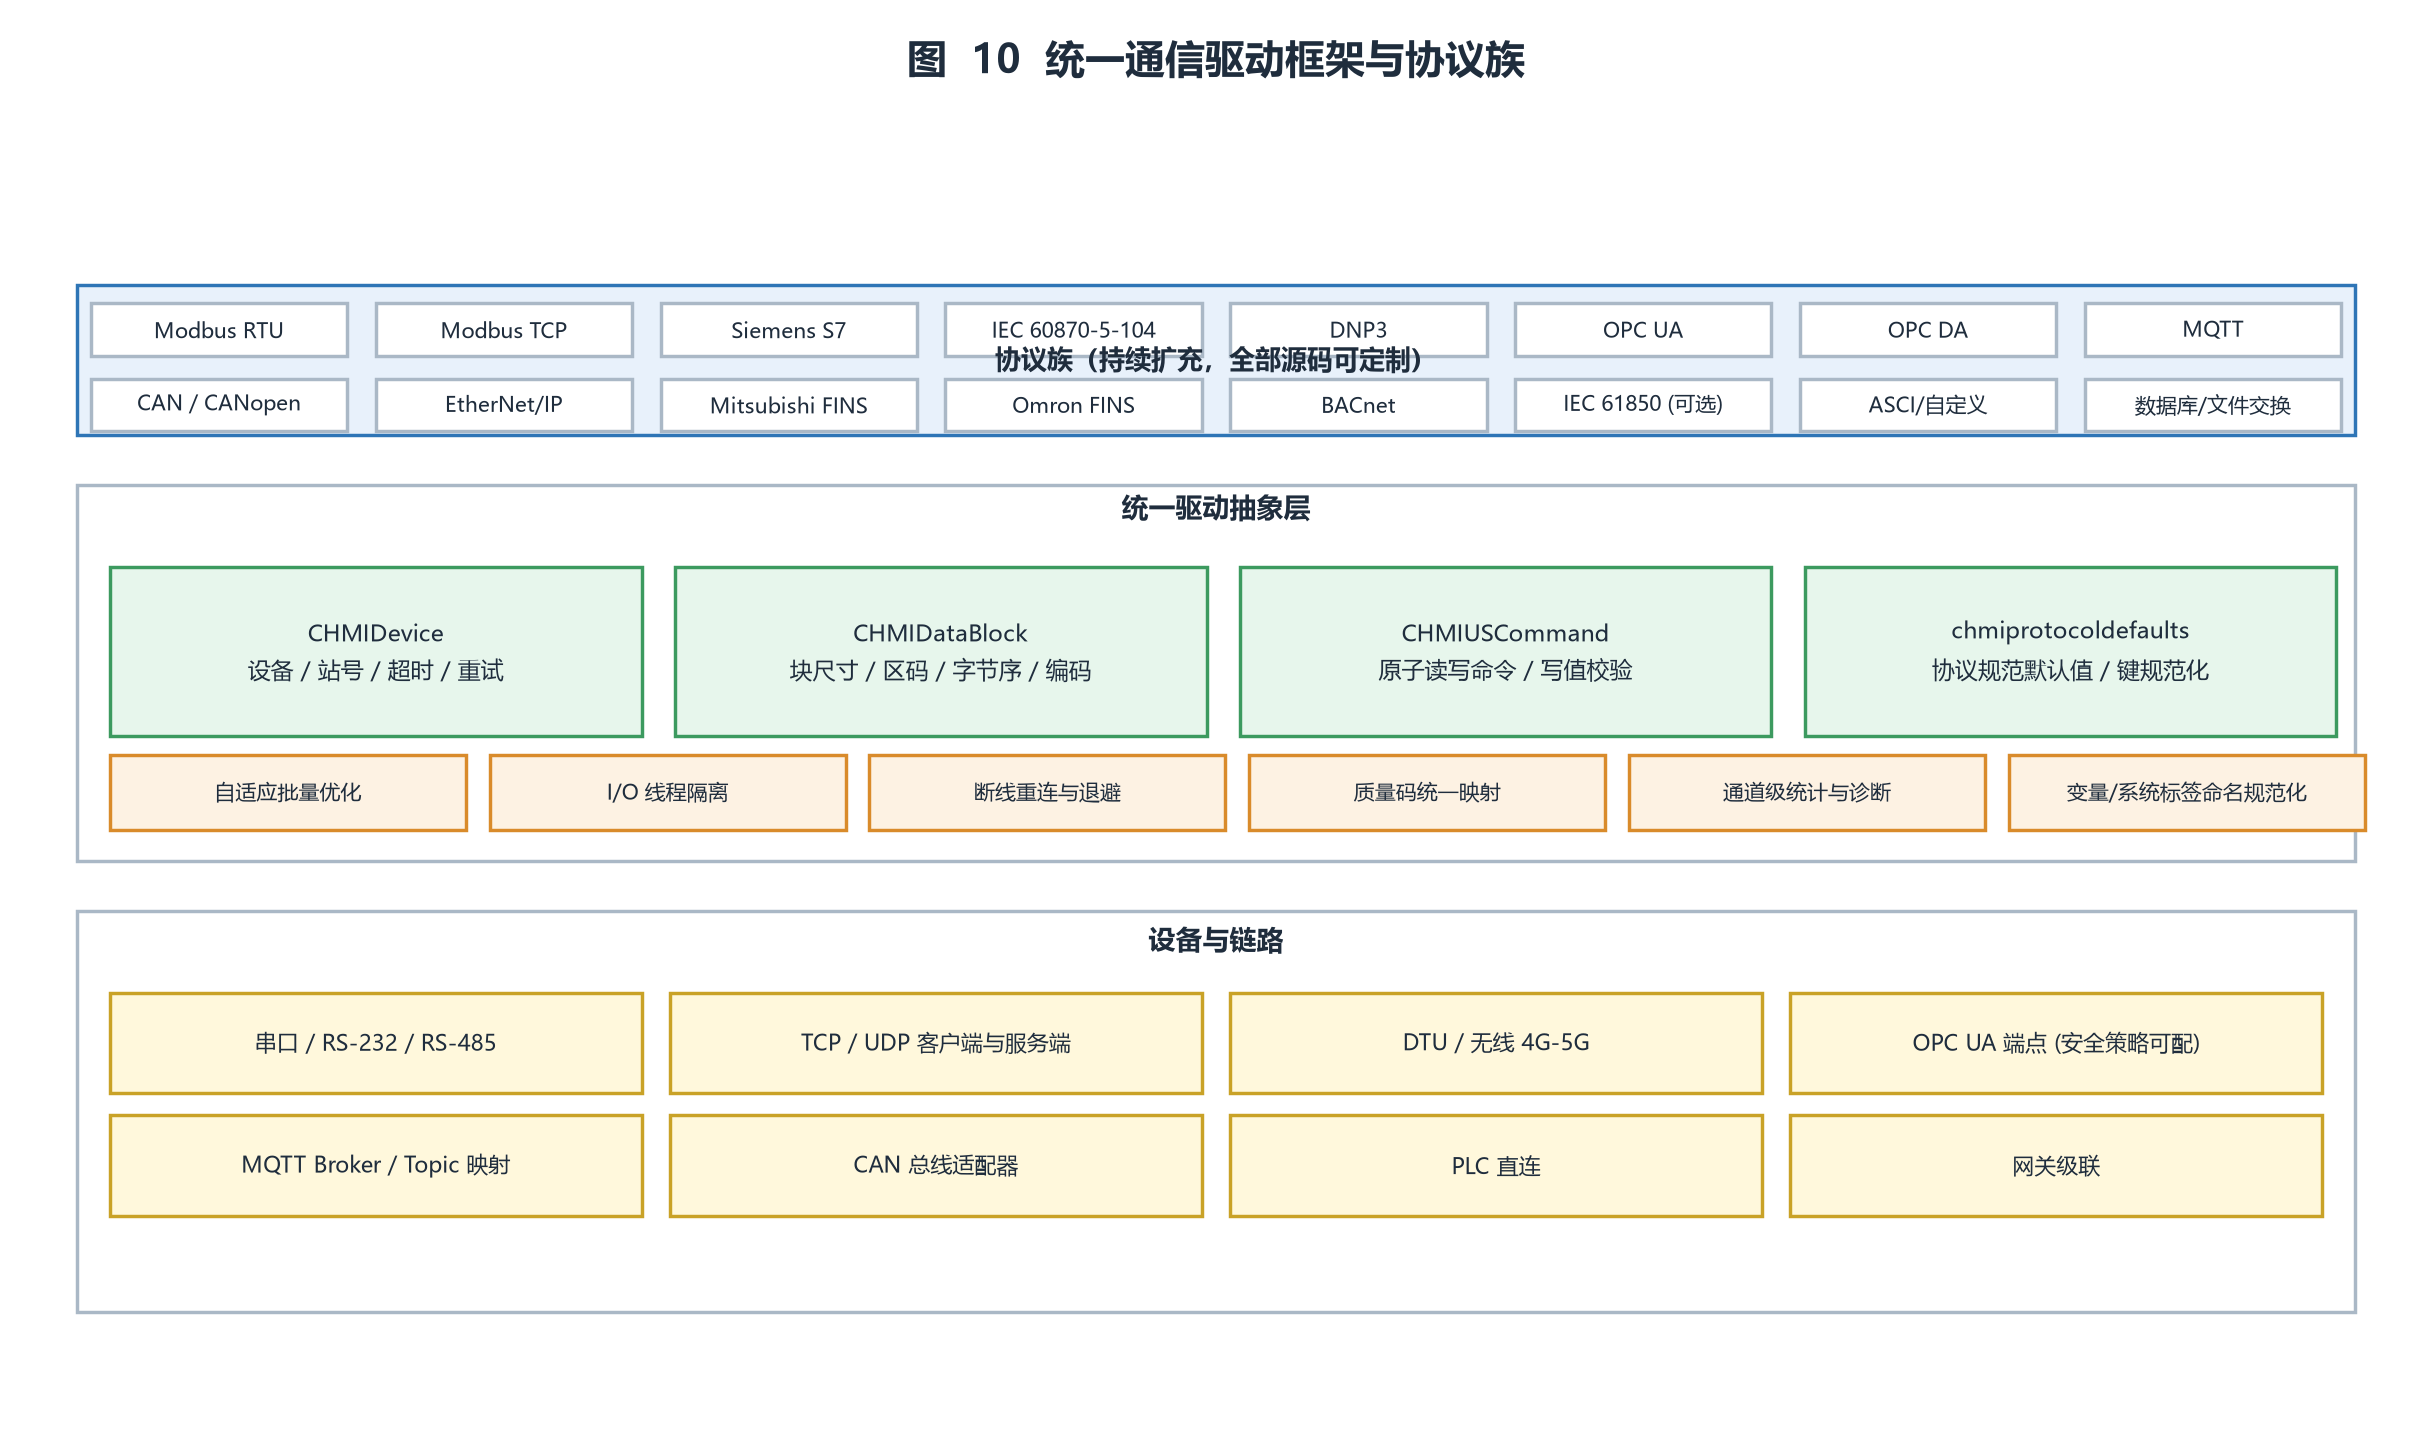 图 10 统一通信驱动框架与协议族
3.6.1 支持的协议族
| 协议族 | 协议 | 典型应用 |
|---|
| 通用现场总线 | Modbus RTU / Modbus TCP / Modbus ASCII | 绝大多数仪表、变频器、PLC、RTU |
| 主流 PLC | Siemens S7(S7comm)、Mitsubishi FINS、Omron FINS、EtherNet/IP(CIP) | 产线设备、机床、专用控制器 |
| 电力与公用 | IEC 60870-5-104、DNP3(含串口/TCP) | 变电站、配电、水务、燃气、管网 SCADA |
| 标准互操作 | OPC UA(含安全策略与订阅/报警条件)、OPC DA | 跨厂商系统集成、上层信息系统对接 |
| 消息总线 | MQTT(含 Broker/Bridge、TLS、Will、Topic 映射) | 物联网平台、云边协同、集团级数据汇聚 |
| 总线与设备 | CAN / CANopen、BACnet | 车辆、工程机械、楼宇自控 |
| 自定义 | 自定义 ASCII / 二进制专有协议、数据库与文件交换 | 非标设备、既有系统数据对接 |
3.6.2 驱动框架的工程价值
| 机制 | 说明 | 价值 |
|---|
| 统一设备抽象 | CHMIDevice / CHMIDataBlock / CHMIUSCommand 三层模型 | 新增协议只需实现抽象接口,自动获得诊断、重连、质量码、统计能力 |
| 自适应批量优化 | 按数据块连续性自动组织批量读取,减少报文数 | 在窄带链路(串口、无线)上效果显著 |
| I/O 线程隔离 | 每个通道独立线程 | 单通道故障不扩散 |
| 断线重连与退避 | 按策略退避重连,重连后按需全量或增量刷新 | 现场网络抖动时数据可自动恢复 |
| 质量码统一映射 | 各协议的质量语义统一映射为平台质量码 | 上层画面、报警、历史对不同的协议表现一致 |
| 通道级统计 | 超时、CRC、溢出、丢弃、序号跳变、重连次数逐台累加 | 把「通信好不好」变成可量化指标 |
3.7 组网与冗余
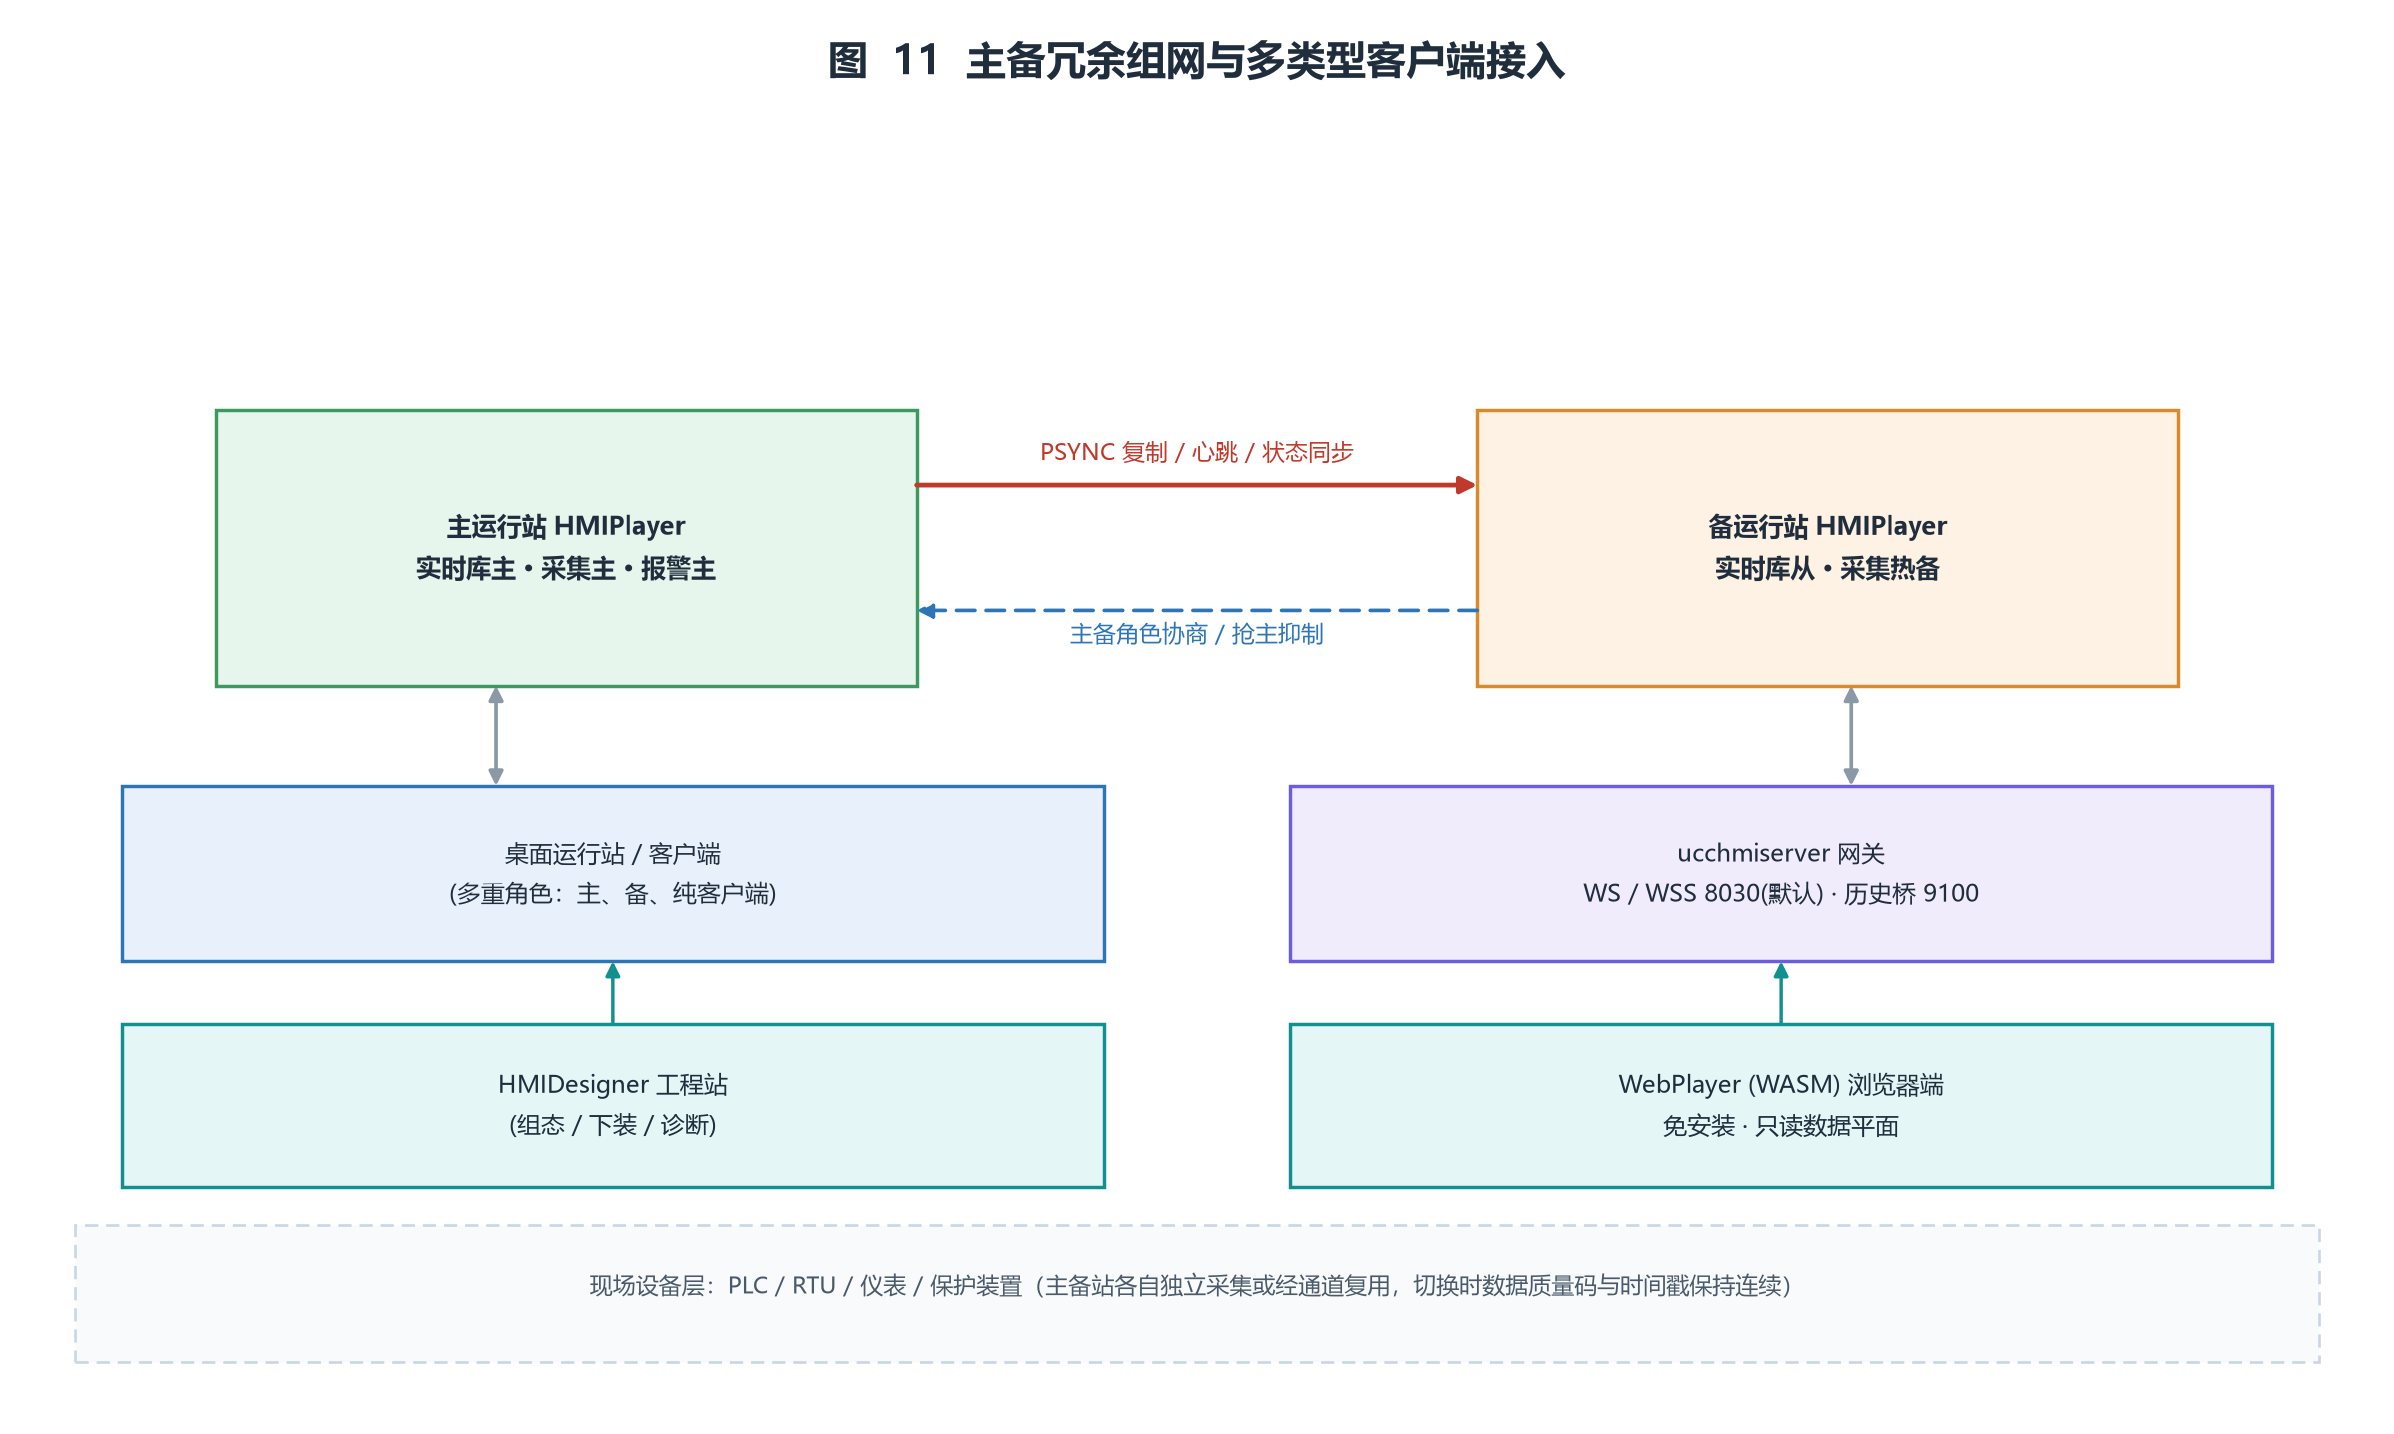 图 11 主备冗余组网与多类型客户端接入
| 冗余要素 | 机制 |
|---|
| 角色 | 运行站可配置为「主」「备」「纯客户端」多种角色 |
| 数据同步 | 实时库主从复制(PSYNC 语义 + backlog),历史与报警分别同步 |
| 心跳与抢主抑制 | 心跳监测 + 边沿锁存(超时/恢复各记一次事件,避免日志刷屏) |
| 切换连续性 | 切换时数据质量码与时间戳保持连续,避免出现「数据空洞」 |
| 客户端接入 | 桌面客户端可同时连接主备,Web 端经网关统一接入 |
| 多站组网 | 支持站间级联与集中监视,站点可只上传增量与统计 |
3.7.1 运行站与 HMICare 的配合
运行站自身不承担「看护自己」的职责,而是把可观测的证据写出来,由 HMICare(见第 5 章)旁路只读消费。这种分工使采集链路与看护链路相互独立:看护不会因为运行站内部异常而失效,运行站也不因看护的引入而增加实时路径开销。
| 契约 | 运行站侧产物 / 参数 | HMICare 侧用法 |
|---|
| 心跳通道 | 命名管道 chmi.hmicare.watchdog(运行站主动上报角色与存活) | 心跳超时判定进程挂起;未启用时以窗口消息 + TCP 探活替代 |
| 通道诊断快照 | chmi_channel_diag.json(逐设备在线/隔离、RTT、扫描落后、超时、坏点) | 读取后产出逐设备的在线率、丢包估算与最差设备定位 |
| 操作审计日志 | operator_journal.log(改限值、趋势配置、登录登出、被拒操作) | 只读增量消费,检测拒绝操作与日志陈旧 |
| 磁盘压力阈值 | CHMIScadaGate::kDiskPressurePercent = 95(到线停写) | HMICare 的磁盘严重线同为 95%,两边门禁口径一致,不互相打架 |
| 时钟阶跃阈值 | kClockJumpWarnMs = 2000(SOE 时间戳可接受阶跃) | SNTP 偏差与本地时钟阶跃使用同一阈值 |
| 长稳内存目标 | kSoakMaxRssKbPerHour = 4096(浸泡门禁内存斜率上限) | 泄漏判定的增长上限取同一常数,看护判据即长稳目标 |
注这套契约的意义在于:「运行站自身的组态约束」与「看护的判定门禁」使用同一组常量。若两边各定一套阈值,现场就会出现「运行站认为正常、看护反复告警」(或相反)的扯皮,而这类扯皮最终会让人关掉告警,使看护能力形同虚设。
3.8 三维可视化
3D 能力用于「设备级数字孪生视图」:把工艺设备(泵、阀、罐、输送线、变配电柜等)以三维模型呈现,并把实时数据绑定到模型的空间与外观属性上,用于集中监视、空间定位与培训演示。
模型导入:基于 assimp 支持常见 3D 模型格式,可组织场景层级与坐标系。
数据绑定:测点可绑定到节点的位置、旋转、颜色、透明度、可见性等属性。
渲染:桌面端使用 OpenGL 渲染,Web 端同样支持(WASM 内渲染)。
性能治理:3D 资源与纹理纳入媒体缓存预算(桌面 64 MiB / Web 8 MiB),页面隐藏或处于高压力时释放 3D 缓存,保证长时间运行不泄漏。
表 3-6 3D 可视化的实现要点与工程约束
| 维度 | 实现要点 | 工程约束与治理 |
|---|
| 场景组织 | 以画面为单位承载 3D 场景,场景内按节点树组织模型与相机;支持多画面/弹出画面中的独立 3D 视图 | 3D 缓冲与页面生命周期绑定,页面隐藏即释放(Web 端页面缓存仅 2 个) |
| 模型与资源 | 通过 assimp 导入模型文件,纹理与网格作为媒体资源管理 | 计入媒体缓存预算,按最旧条目淘汰;Web 端预算 8 MiB |
| 数据绑定 | 实时测点驱动节点属性:位移/旋转/缩放、颜色映射、透明度、可见性、状态切换 | 绑定走统一数据通路,与二维图元共享同一实时数据源,保证 2D/3D 视图数值一致 |
| 渲染管线 | OpenGL 渲染,桌面与 Web(WASM) 共用同一渲染逻辑 | Web 端受固定 512 MiB 堆约束,需按预算控制纹理尺寸与模型复杂度 |
| 交互 | 支持旋转、缩放、平移、节点拾取与点击事件,可联动二维画面与报警 | 交互事件纳入既有的权限与审计体系 |
| 长稳运行 | 3D 场景反复进出不产生资源泄漏 | 压力分级回收时同步释放隐藏页面的 3D 缓冲(reclaimHiddenShapeTree) |
注Web 端的 3D 是「可用的 3D」,不是「演示用 3D」:桌面端适用于复杂设备孪生与高精度模型;Web 端适用于设备定位、状态映射与集中监视类场景。两者的资源预算差异是显式的、可配置的——这正是「同一内核、两套预算」设计原则在 3D 上的具体体现。
3.9 大规模实例的工程策略
百万点级工程不能依赖默认配置跑到底。平台把大规模场景下的关键策略参数化为可配置常量(多数可通过环境变量或配置项调整),覆盖订阅、UI 刷新、实时库写入、死区、全量同步、报警队列、历史队列与热点集合等维度。
| 策略域 | 控制内容 | 作用 |
|---|
| 订阅规模 | 单客户端订阅上限、订阅合并与去重 | 避免热点画面把所有测点都拉进一次刷新 |
| UI 刷新批处理 | UI 更新批量大小与刷新节流 | 把「每点一次重绘」变为「批量重绘」,保证帧率 |
| 实时库写入 | 写入摄取开关与批量提交 | 大规模下按需开启/关闭写入摄取,保护实时库 |
| 实时数据死区 | 全局死区与测点级死区 | 减少无意义的刷新与历史写入 |
| 全量同步 | 全量同步周期与增量补齐策略 | 平衡「数据完整性」与「通信/CPU 开销」 |
| 报警与历史队列 | 队列容量与溢出策略 | 突发报警风暴下不丢失关键报警 |
| 百万点热点策略 | 热点集合规模与淘汰 | 把有限内存用在真正被访问的测点上 |
3.10 性能与技术指标汇总
表 3-7 HMIPlayer 关键指标汇总
| 类别 | 指标 | 数值 / 说明 | 口径 |
|---|
| 组态规模 | 测点数量 | 1 426 002(实测通过) | 实测参考 |
| 有效数据内存 | 140 B/点 | 实测参考 |
| 百万点常驻内存预算 | 约 300~350 MiB 注册表 + 运行时开销 | 容量规划口径 |
| 长稳 RSS 漂移 | 0.230%(1.12 M 次读写混合) | 实测参考 |
| 组态性能 | 按 ID 查找 | 148 ns / 6.76 M ops/s | 实测参考 |
| 按名查找 | 680 ns / 1.47 M ops/s | 实测参考 |
| 热数据批量写 | 45.6 ns/点 / 21.9 M ops/s | 实测参考 |
| 实时库 | GET 单连接 | 8 363 ops/s,p50 108.9 μs | 实测参考(32 B) |
| GET 8 并发 | 15 972~16 386 ops/s | 实测参考(32 B) |
| SET 20 万键 | 151.5k ops/s(6.6 μs/op) | 优化后实测 |
| 逐出开销 | 10.1 μs/次,与分片规模解耦 | 优化后实测 |
| 历史库 | 压缩编码 | Gorilla / Delta / SwingDoor 按块选优 | 设计规格 |
| 掉电保护 | WAL 预写日志 + 重放 | 设计规格 |
| 健康阈值 | WAL 失败 → 红;WAL > 512 MB → 琥珀 | 运维阈值 |
| UI 与呈现 | 实时曲线点数上限 | 桌面 100 000 / Web 4 000 | 代码常量 |
| 历史曲线点数上限 | 桌面 20 000 / Web 8 000 | 代码常量 |
| 页面缓存 | 桌面 16 / Web 2 | 代码常量 |
| 服务能力 | WebSocket 服务端口 | 默认 8030(可配) | 配置默认值 |
| 单帧上限 | 桌面 32 MiB / Web 8 MiB | 代码常量 |
| 待发二进制缓冲 | 桌面 16 MiB / Web 4 MiB | 代码常量 |
| 报警 | 报警队列容量 | 桌面 8 000 / Web 64 | 代码常量 |
| SOE 查询上限 | 桌面 10 000 / Web 2 000 | 代码常量 |
| 运行看护契约 | 看护心跳通道 | 命名管道 chmi.hmicare.watchdog | 配置默认值 |
| 通道诊断快照 | chmi_channel_diag.json,写入周期 60 s,陈旧判定 180 s | 配置默认值 |
| 进程内存告警 / 重启线 | 1024 MiB / 2048 MiB | 配置默认值 |
| 泄漏斜率上限 | 4096 KB/h(与浸泡门禁同源) | 代码常量 |
3.11 与专业 SCADA 的对比
下表从运行站的技术实现角度进行对比。对比对象为国际主流 SCADA 与国产主流组态软件。
| 对比项 | 专业 SCADA 的一般做法 | UCanCode 平台的做法 | 差异 |
|---|
| 实时数据引擎 | 进程内变量表为主,或提供独立的实时库选件 | 内建内存数据库,RESP 兼容命令面 + 持久化 + 复制 + 全量 INFO | 可被外部客户端直接读写,可做灾备与二次开发 |
| 内存治理 | 依赖操作系统与运营商经验,缺少键/点级记账 | 键级与点级内存记账、容量硬上限、淘汰与背压指标 | 内存问题从「凭经验」变为「凭指标」 |
| 历史库 | 依赖商用关系库或文件,压缩与索引能力有限 | 自研时序库:多编码压缩 + WAL + 分片 + 有界索引 + 压缩比可观测 | 容量与性能均可量化 |
| 百万点 | 通常需要分区、分站或额外服务器堆叠 | 单引擎支撑百万点组态,内存与性能有实测口径 | 架构更简单,运维成本更低 |
| UI 阻塞 | 部分产品在大数据量查询时出现可感知卡顿 | I/O 线程隔离 + 线程池异步取数 + 连接独占与防饿死 | 操作体验在大工程下更稳定 |
| Web 与桌面一致性 | Web 为独立产品线,功能通常是桌面的子集 | 同一内核编译为 WASM,功能对等(按内存预算裁剪上限值) | 一次组态、两种形态,语义一致 |
| 可观测性 | 厂商工具为主,指标口径封闭 | INFO 全量指标 + 系统指标中心 + SCADA 业务指标 + 5 页签监控面板 | 指标可读源码、可扩展、可对接第三方监控 |
| 开放与定制 | 插件/脚本级扩展,内核不可改 | 全栈源码 + 统一驱动框架 + 可替换内核组件 | 从「配置产品」变为「掌握平台」 |
| 运行看护与自愈 | 多数不提供进程级看护;挂起与「静默停写」类故障需人工发现 | 运行站导出心跳、通道诊断快照与操作审计流水,由 HMICare 统一看护与自愈 | 看护链路与采集链路解耦,判定门禁与运行站常量同源 |
注客观说明:国际主流 SCADA 在第三方生态(驱动库、行业套件、认证)与全球服务网络上仍具优势;本平台的应对方式是「源码开放 + 统一驱动框架 + 标准协议(OPC UA/MQTT)」,把生态问题转化为可由用户或集成商自行解决的问题。